

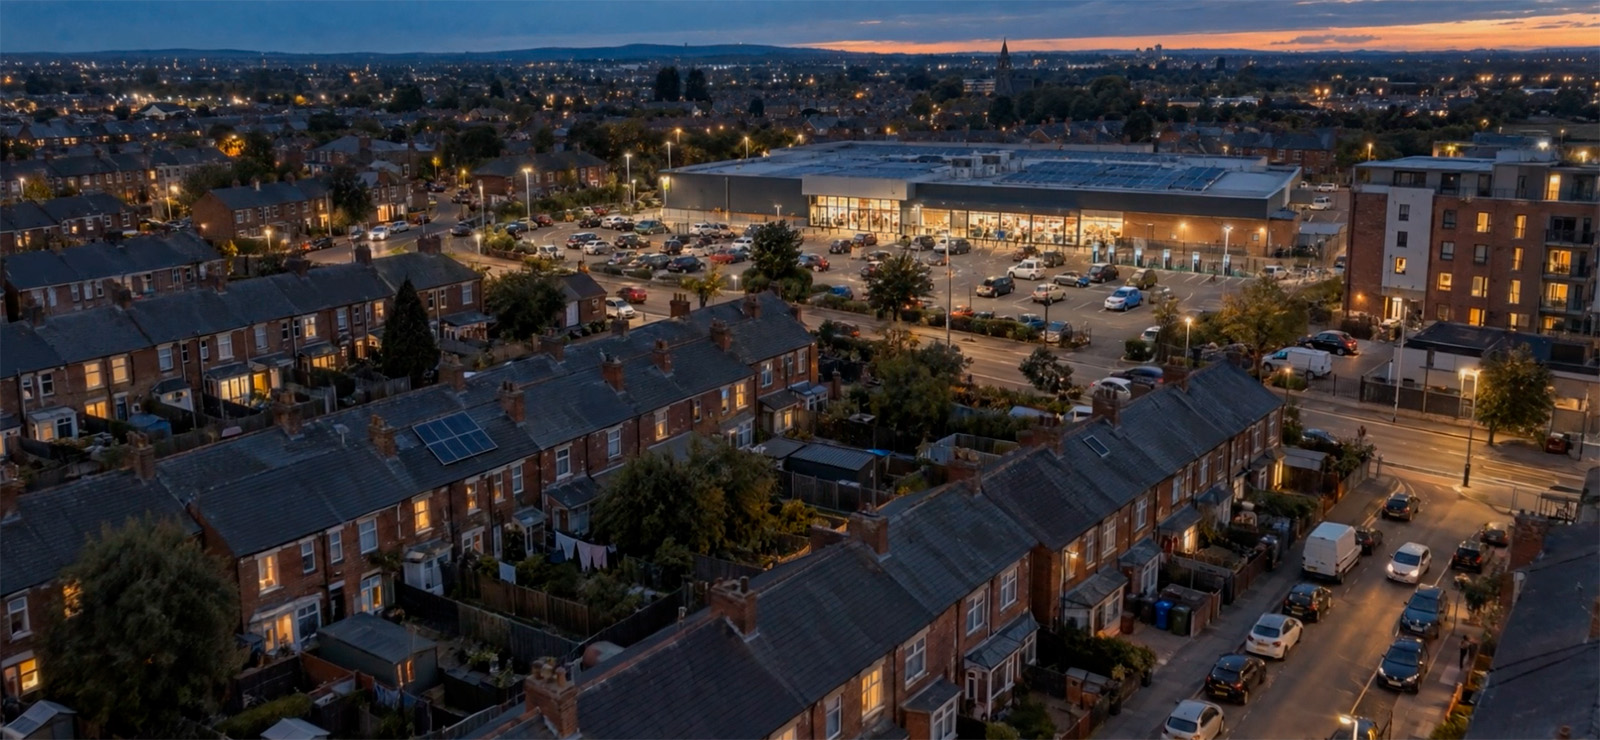
Llevamos quince años trabajando con Worldpanel by Numerator. Es un cliente que conocemos muy bien.
A principios de septiembre nos llegaron con un nuevo brief. Iban a organizar How Britain Shops: Then · Now · Next, una jornada en el Design Museum de Londres. El público eran perfiles sénior de los sectores de gran consumo y retail: responsables de categoría, insights, marketing y comercial. Algunos eran clientes de muchos años. Otros eran potenciales clientes que conocían a Worldpanel por primera vez.
El evento también tenía un objetivo concreto. Worldpanel iba a anunciar el mayor cambio en su panel de Gran Bretaña en años: de 30.000 a 55.000 hogares, y en torno al triple de visitas a tienda.
Nuestro vídeo era lo primero que iba a ver la sala. Dos minutos para marcar el tono de toda la jornada. El brief dejaba claro lo que no debía ser: «ni un showreel corporativo ni un anuncio de producto». Tenía que sentirse como el inicio de una historia importante, y llevar a la sala de «me acuerdo de eso» a «quiero ver qué viene después».
En un museo del diseño, y ante ese público, tenía que verse muy bien.
El desafío
En cuanto leímos el brief, el proyecto nos enamoró, pero también vimos un reto. El vídeo empezaba en 1996, así que teníamos que mostrar cómo era hacer la compra en Gran Bretaña en aquella época. Después, el vídeo pasaría al presente, y de ahí a lo que viene.
La parte actual era terreno conocido. La de 1996, no.
Durante quince años, la mayoría de los vídeos que hemos hecho para Worldpanel se han construido con imágenes de stock. Hemos pasado muchísimas horas en bancos de imágenes. El problema nunca fue encontrar clips. Era lo que esos clips podían decir. El trabajo de Worldpanel es específico y lleno de matices. El stock es genérico. Demasiadas veces acabábamos con clips que llenaban la pantalla pero no significaban nada visualmente: gente mirando un portátil, manos sobre un teclado, una calle llena de gente. Relleno.
Para la Gran Bretaña de 1996, el stock ni siquiera era una opción. ¿Una familia concreta, haciendo una compra concreta, en un supermercado que parezca de 1996 y de ningún otro sitio? Investigamos en internet qué había disponible. No había nada ni parecido.
Así que propusimos algo nuevo. Generaríamos con IA la parte de 1996. Después haríamos el resto con una mezcla de stock e IA, más cerca del trabajo que hacemos para Worldpanel en el día a día.
Dijeron que sí. Teníamos tres semanas.
También era un reto para nosotros. Ya usábamos IA en nuestras producciones: un plano aquí, un arreglo allá. Pero este era el primer vídeo que planteábamos generar casi por completo. Al final, todos los planos menos uno se hicieron con IA. La voz en off también es IA. La música salió de un banco de música, y era exactamente la que el vídeo necesitaba.
El workflow de producción con IA
Lo primero que hicimos no fue visual. Creamos un proyecto en Claude y le dimos el brief. A partir de ahí, Claude trabajó con nosotros durante toda la producción, con un chat distinto para cada tarea.
Un chat fue para investigar. Un vídeo ambientado en 1996 necesita muchos pequeños detalles bien resueltos. ¿Qué coches habría aparcados frente a un supermercado? ¿Cuál era el coche familiar más común? ¿Las bolsas de la compra eran de plástico o de papel?
En algunos proyectos escribimos un guion audiovisual antes de que exista nada visual. Es una tabla que describe cada plano con palabras, junto a la frase de la voz en off que le corresponde: duración, composición, acción y de dónde sale cada plano. En este vídeo era imprescindible. En una producción con IA, el storyboard no puede existir hasta que existen las imágenes, y las imágenes no pueden existir hasta que cada plano está descrito.
Claude escribió la primera versión en otro chat, a partir del brief: 58 planos, sincronizados con la voz en off. Era un borrador bastante flojo, muy «average». Cubría todo lo que pedía el brief y tenía algunas buenas ideas. Pero le faltaba originalidad y no tenía un punto de vista propio. Es un buen punto de partida, pero con eso no se hace un vídeo. Así que lo hicimos nuestro. Lo rehicimos, lo corregimos, quitamos ideas y añadimos las nuestras, y seguimos iterando con Claude sobre nuestra versión hasta que sentimos que funcionaba.
También fuimos claros con el cliente sobre para qué servía este documento. Por ahora, la generación con IA no es una ciencia exacta. Algunos planos no funcionarían, y solo lo sabríamos al intentar hacerlos.
Por eso le pedimos que confirmara solo las decisiones que salen caras de cambiar más adelante: la estructura general y las relaciones de aspecto. Todo lo demás, a nivel de plano, quedaba abierto. La aprobación de verdad llegaría con el storyboard, con imágenes reales delante.
El orden de trabajo fue:
- Guion AV, aprobado por el cliente.
- Una imagen de casting: la familia, la estética y el supermercado en un solo fotograma, aprobada por el cliente.
- Fichas de personaje y referencias de localización, creadas a partir de esa imagen.
- Fotogramas: un fotograma inicial para cada plano.
- Storyboard con esos fotogramas, enviado con la voz en off y las opciones de música, aprobado por el cliente.
- Clips de vídeo, generados a partir de los fotogramas aprobados.
- Montaje, diseño de sonido y etalonaje.
La idea detrás de este orden es sencilla. Conseguir la aprobación sobre lo más barato que todavía puede estar mal. Una imagen de casting cuesta una generación. Descubrir en el storyboard que la madre parecía demasiado joven habría costado cincuenta.
También decidimos hacer primero el acto de 1996, por separado, antes de tocar el resto. Era la parte más difícil y marcaría el nivel visual de todo lo demás. El resto del vídeo estaba más cerca de lo que llevamos quince años haciendo para Worldpanel. Si 1996 funcionaba, lo demás vendría solo.
Por qué tres aspect ratios
Cada decisión en un vídeo debe tener un motivo. La relación de aspecto es una de nuestras herramientas, y en este vídeo la usamos para mostrar el paso del tiempo.
El evento se llamaba Then · Now · Next, así que el vídeo tiene tres actos. Cada acto tiene su propio formato.
Then es 4:3, la forma de un televisor de los noventa.
Now es 16:9, el formato en el que todos la vemos hoy.
Next se abre a un panorámico 21:9.
El público no necesita un rótulo para saber que el tiempo ha pasado. Se lo dice la pantalla.
Los cambios ocurren dentro de las frases de la voz en off, no entre ellas.
El formato pasa de 4:3 a 16:9 en la palabra «barcodes» (códigos de barras), justo en el momento en que el vídeo pasa del antiguo método de recogida de datos a la captura de datos moderna.
Se ensancha a 21:9 cuando se presenta el nuevo panel de Worldpanel.
Y vuelve a abrirse a 16:9 completo para el título final, así que lo último que hace el vídeo es completar el encuadre.
Y todo va dentro de un máster de 1920 × 1080.
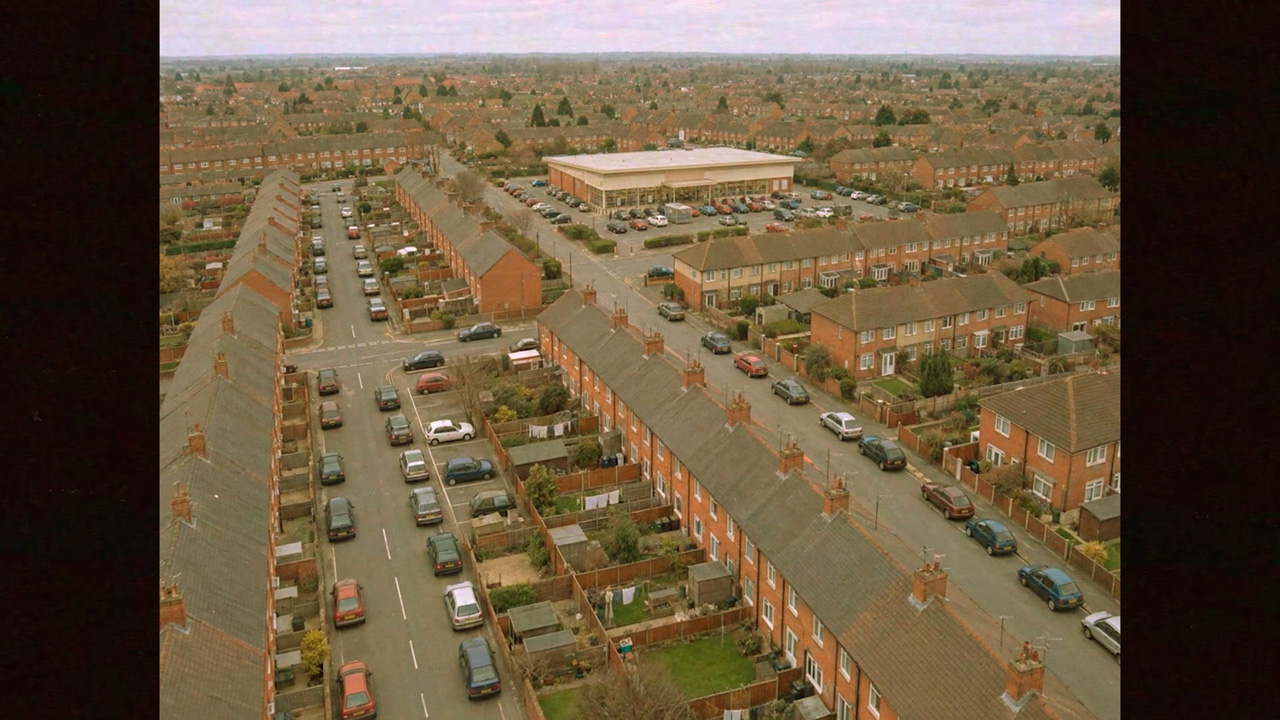
Then
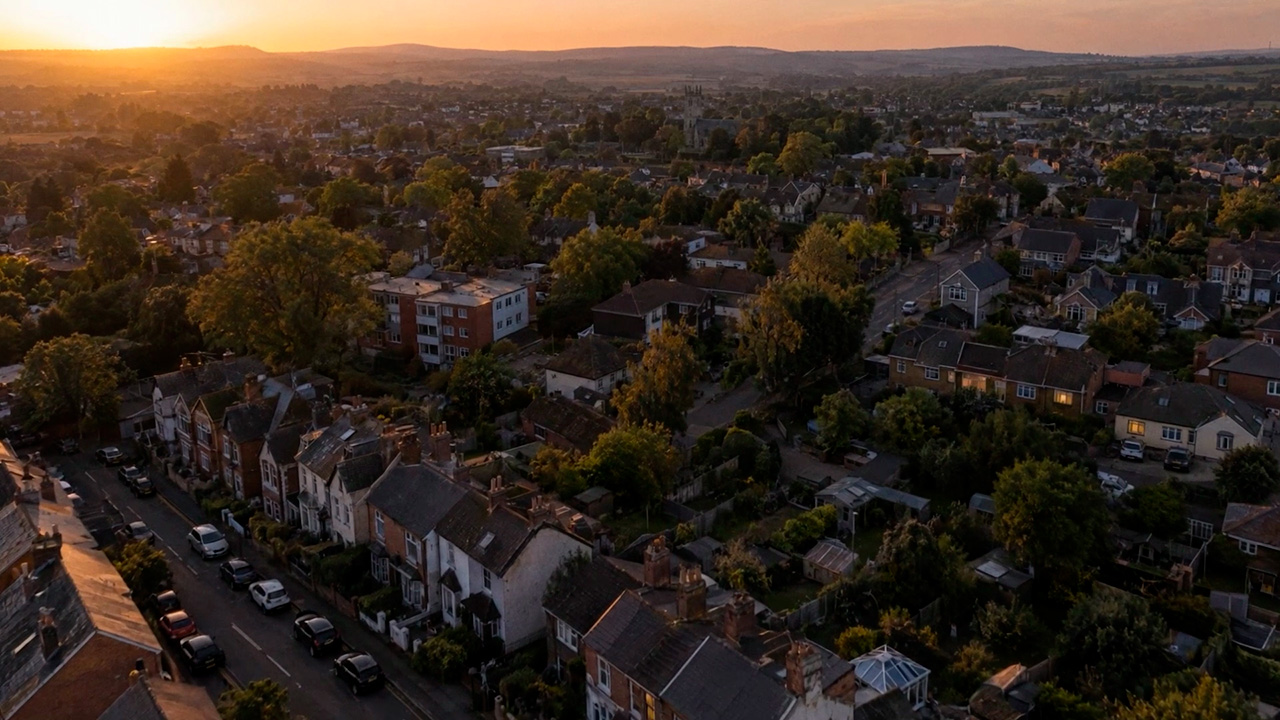
Now
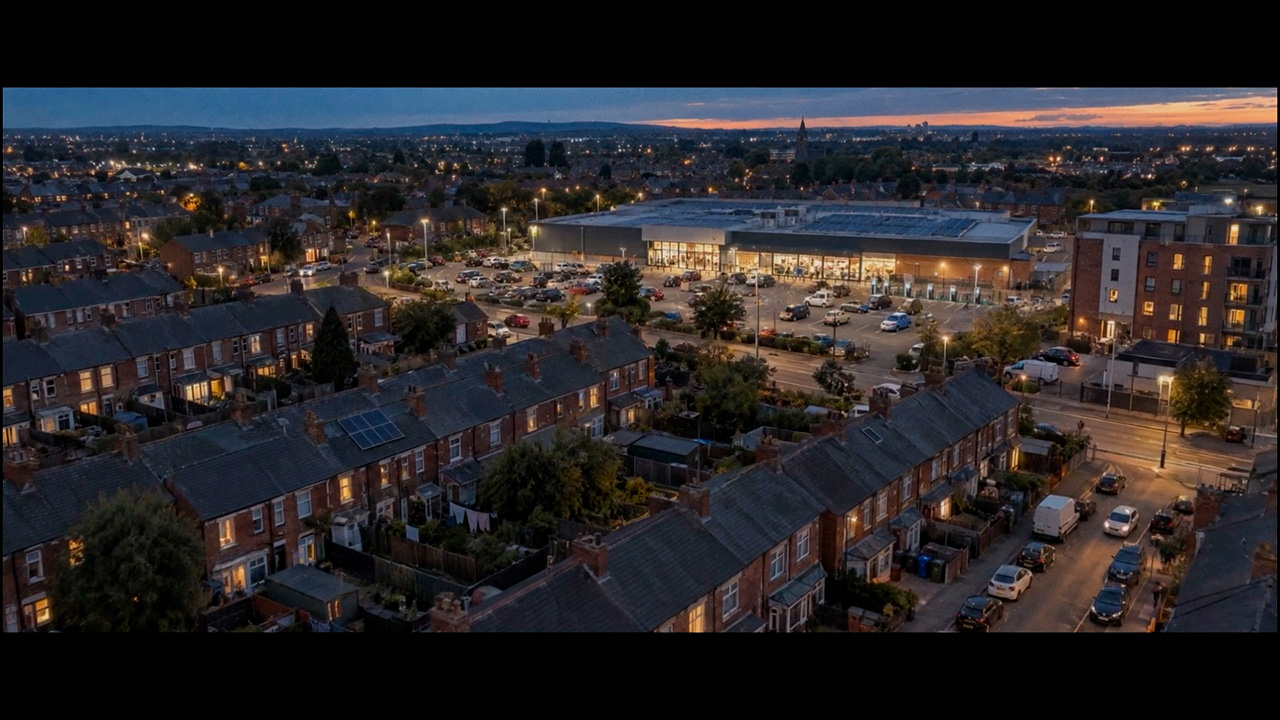
Next
Empezando por lo más difícil. Gran Bretaña, 1996
Primero, definir la fotografía
Antes de generar nada, decidimos qué tipo de fotografía iba a tener este vídeo. No los colores ni el etalonaje, sino la forma de mirar a la gente.
Nuestra referencia fue el realismo social británico: la tradición documental que muestra a gente corriente en lugares corrientes, sin hacerla parecer mejor de lo que es. Piensa en directores como Ken Loach o Andrea Arnold.
Esta decisión hizo más trabajo del que parece. Un modelo de imagen no tiene gusto propio. Si lo dejas solo, te da un acabado pulido, favorecedor, publicitario. Un estilo fotográfico definido nos dio algo que describir en cada prompt: luz disponible, habitaciones reales, caras corrientes, momentos que parecen captados, no preparados. Es lo que hizo que cincuenta planos, hechos con distintos modelos a lo largo de tres semanas, parecieran un solo vídeo.
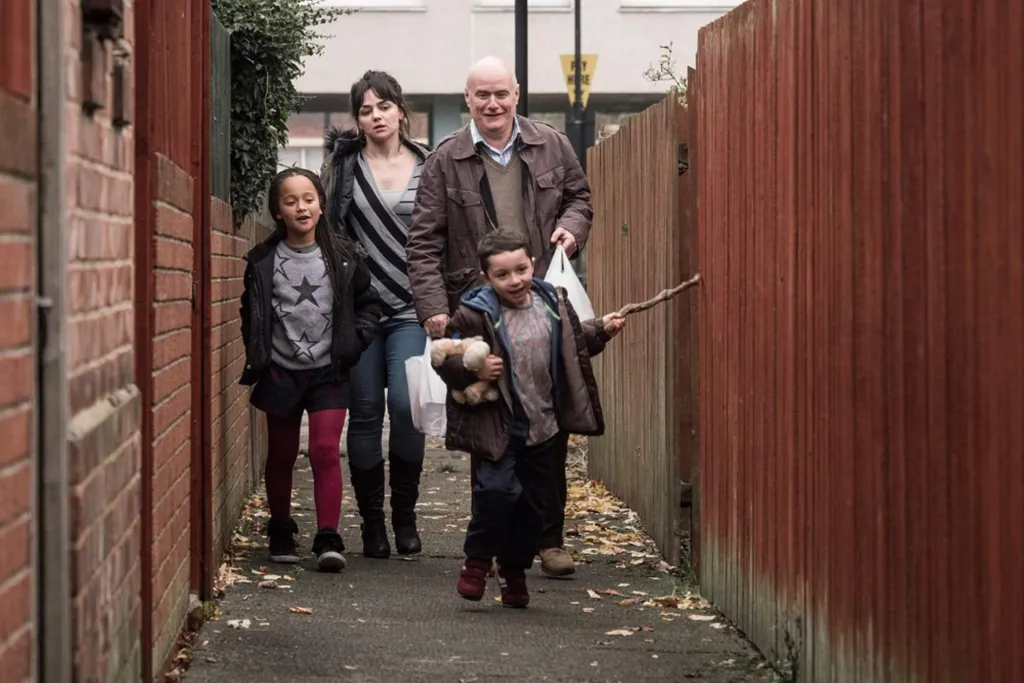
De la película «I, Daniel Blake» de Ken Lach
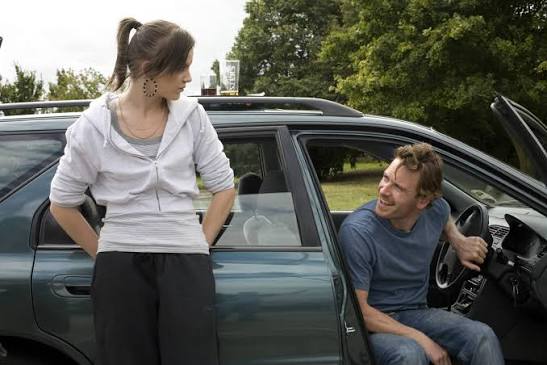
De la película «Fish tank» de Andrea Arnold
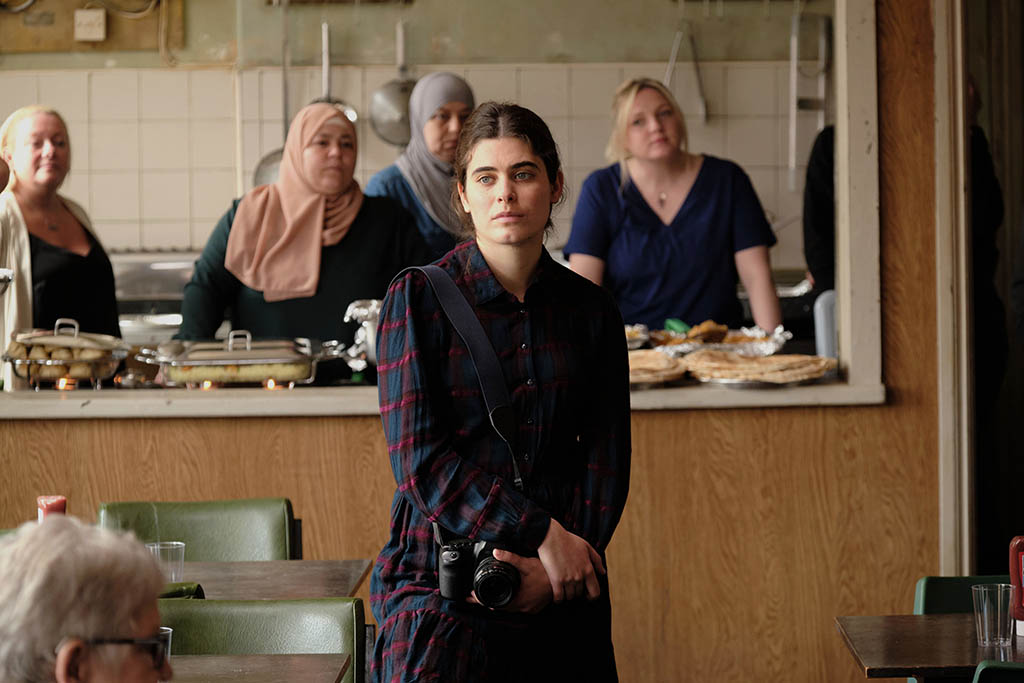
De la película «The old oak» de Ken Lach
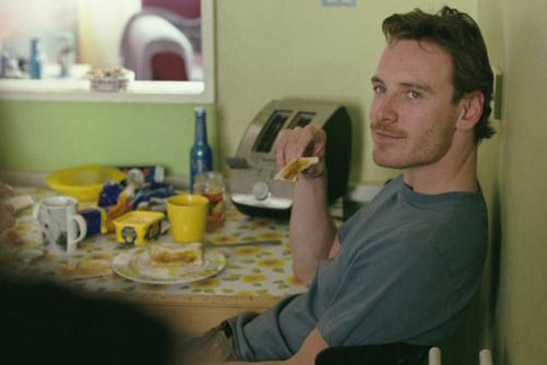
De la película «Fish tank» de Andrea Arnold
Una imagen para empezar
Empezamos por el reparto. El cliente tenía claro quién debía estar en la tienda:
«Yo pondría a la madre con 2 o 3 hijos de unos 13, 9 y 4 años. Creo que habría sido más raro ver a la madre, el padre y todos los hijos haciendo la compra en el supermercado a la vez.»
Fue una buena observación, y se convirtió en la familia protagonista del acto de 1996.
Después hicimos una sola imagen: la familia en un pasillo del supermercado. Los cuatro mirando directamente a cámara, quietos y formales, como en una foto de casting.
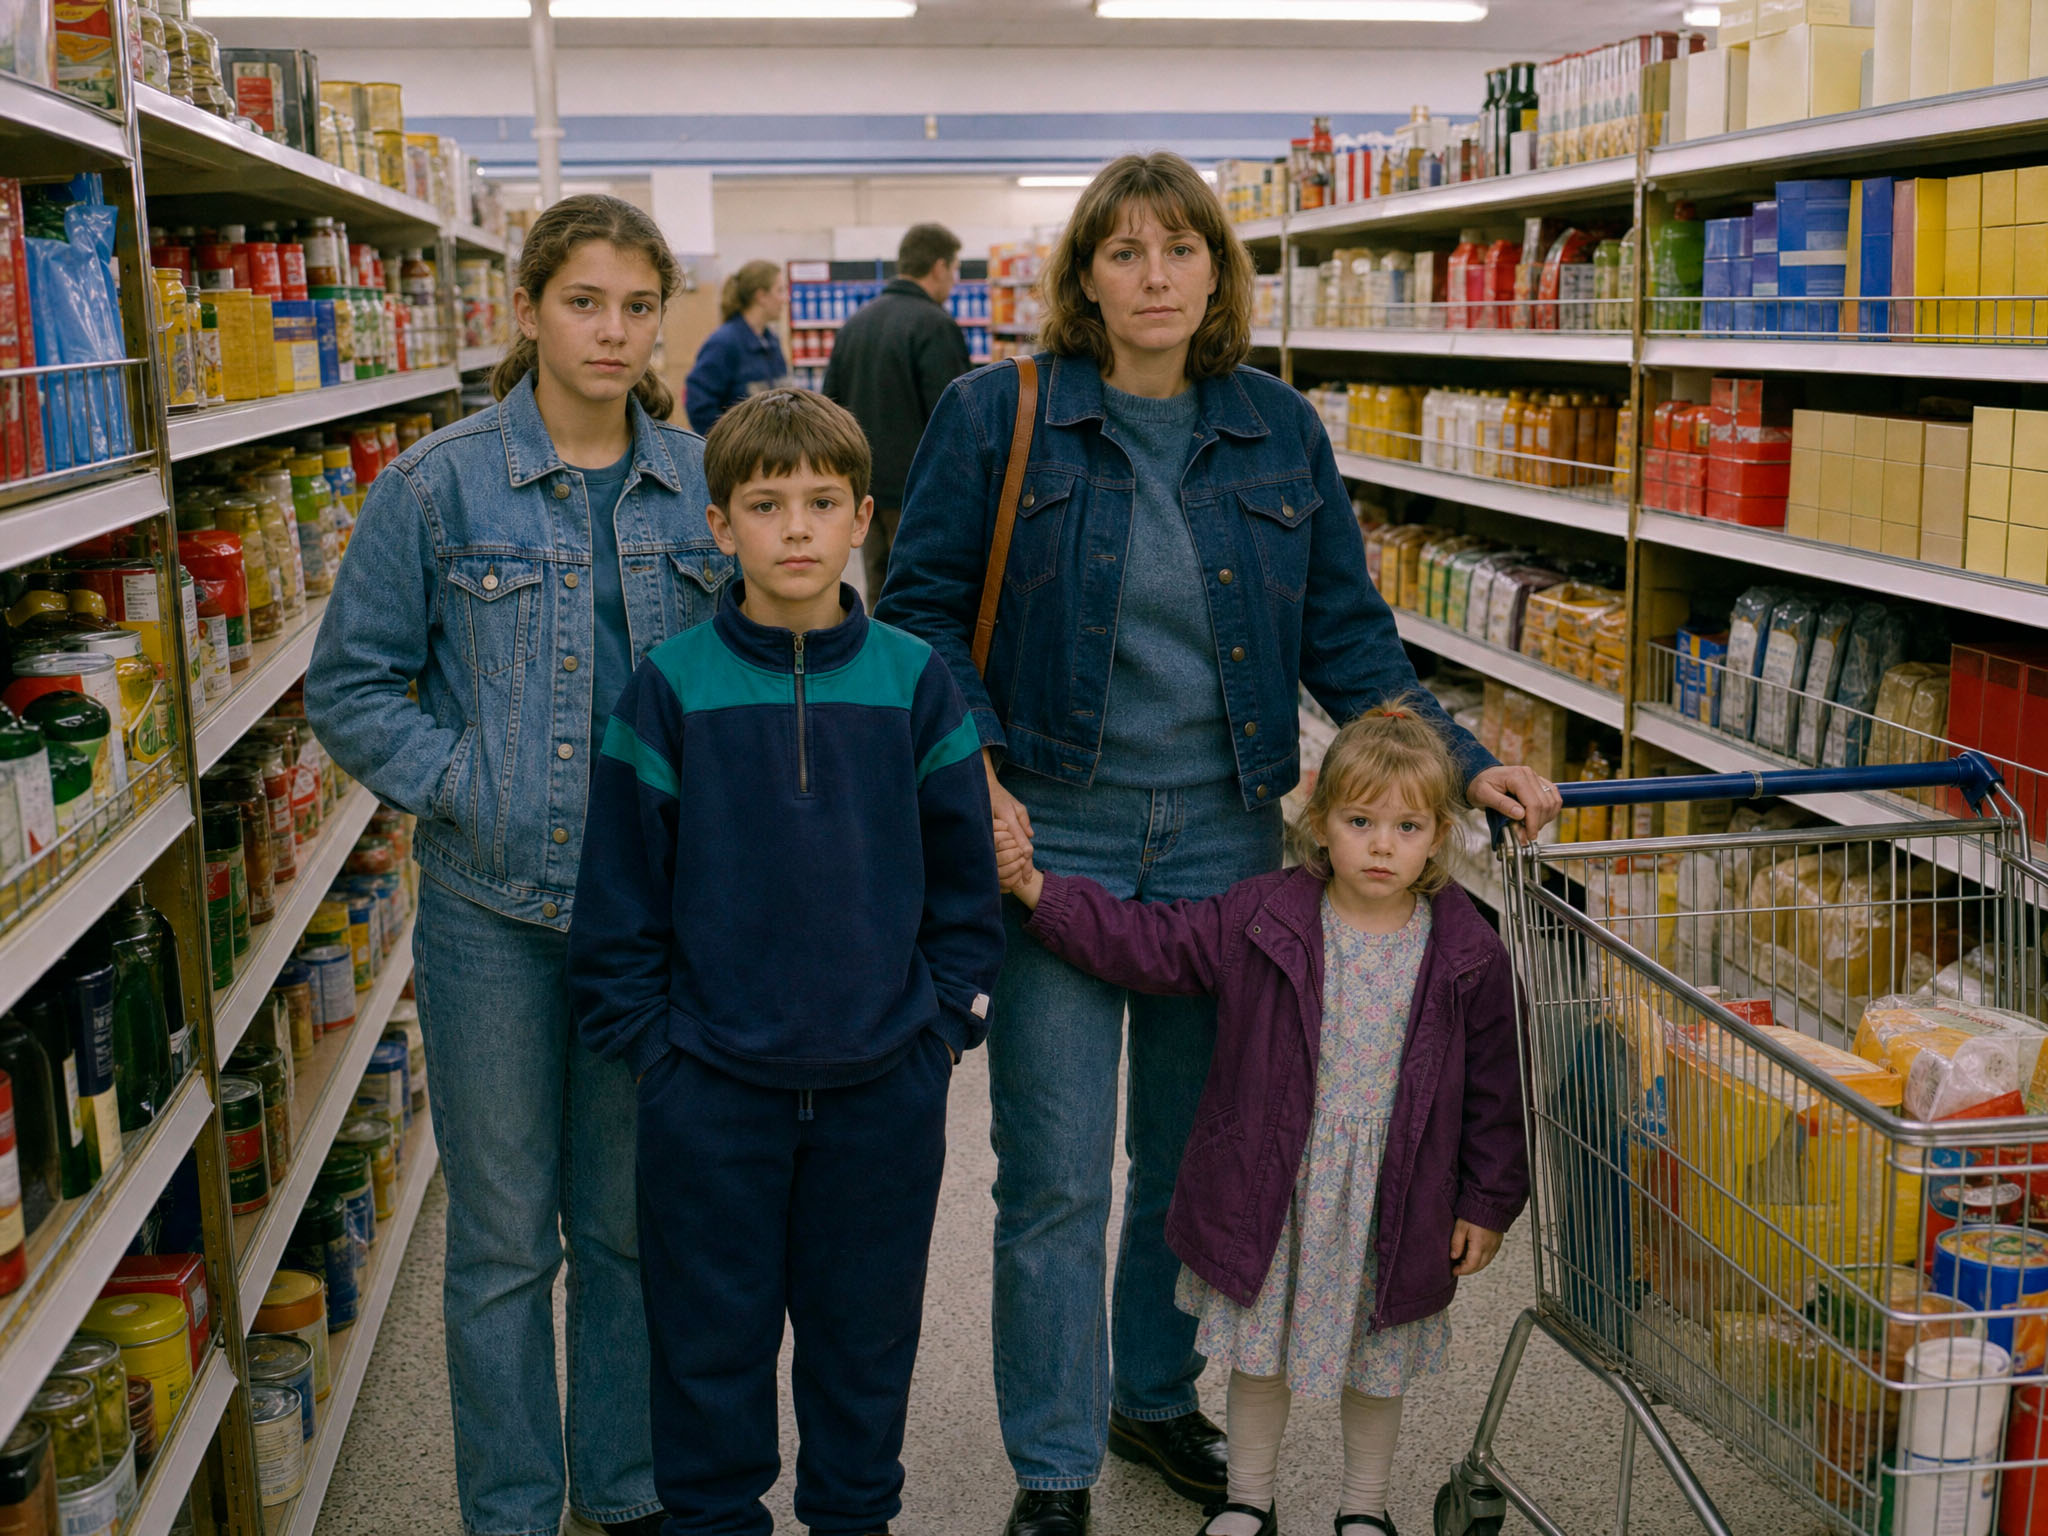
Esa única imagen permitió al cliente aprobar tres cosas a la vez. La estética del vídeo. El reparto. Y la localización. La pregunta era sencilla: ¿son estas las personas adecuadas, en el mundo adecuado?
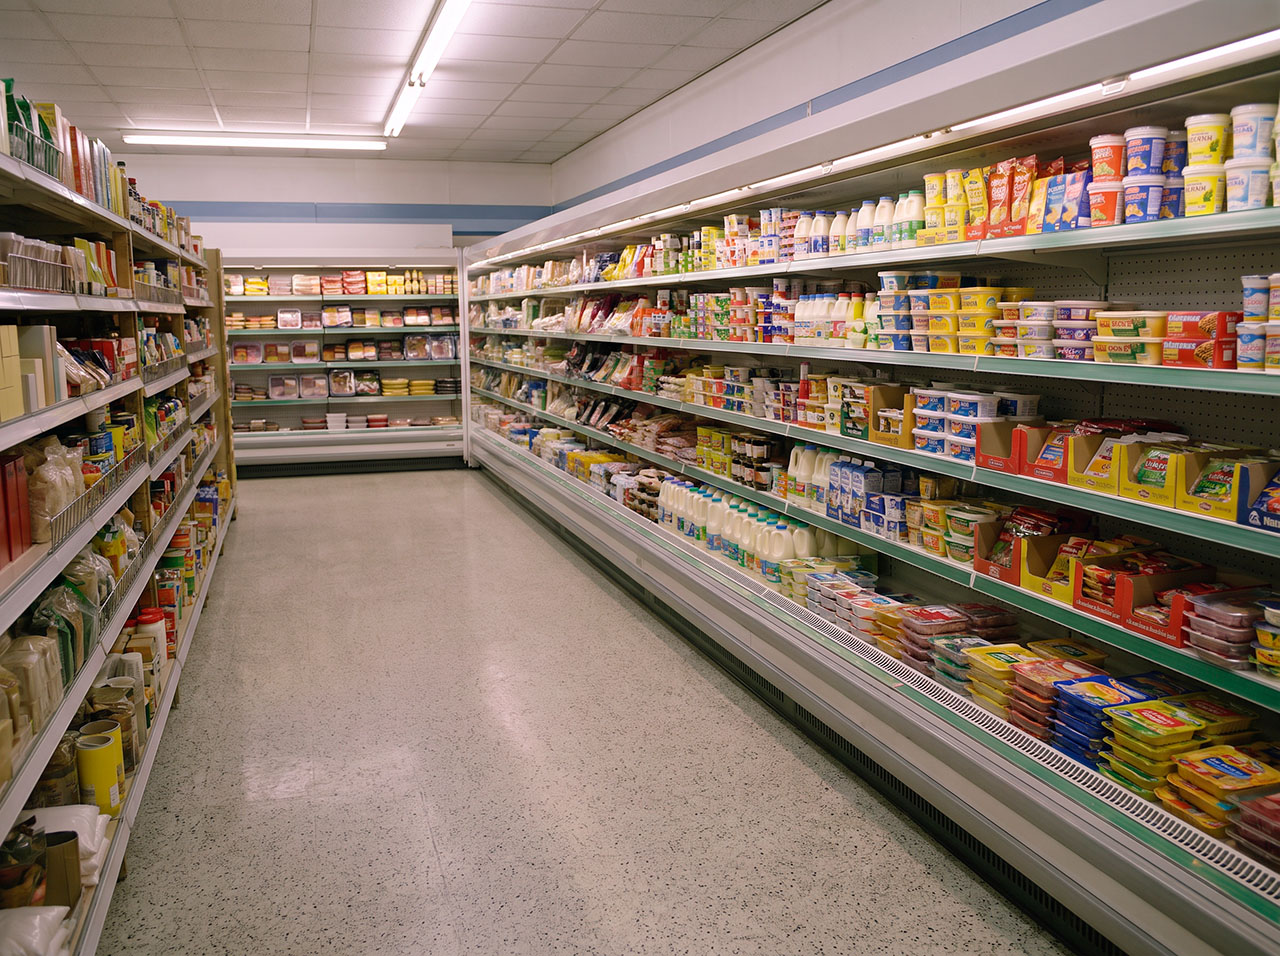
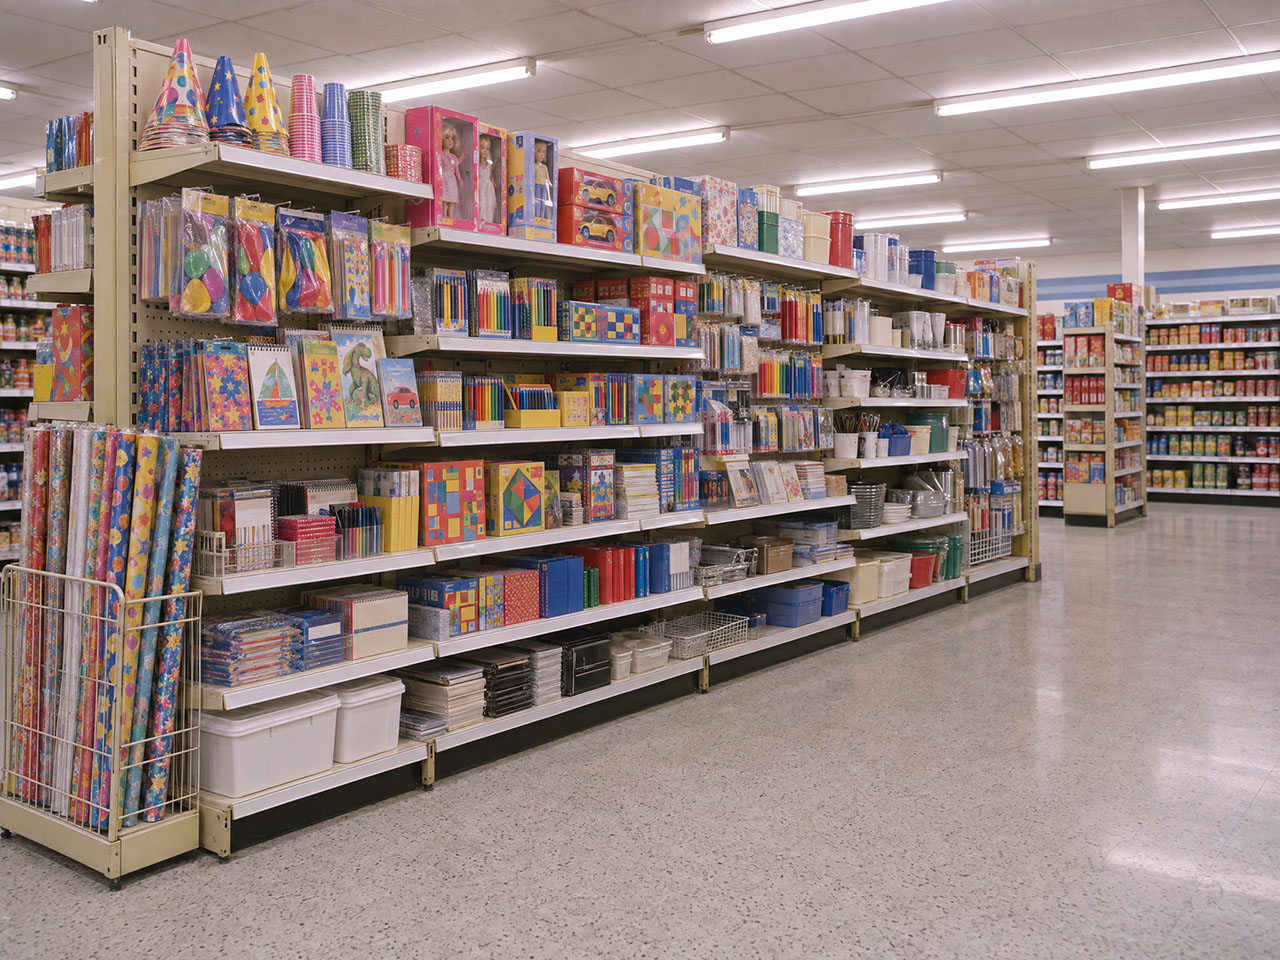
El supermercado era un reto en sí mismo. No podía tener marcas reales, ni logotipos, ni nombres legibles. Pero tenía que parecer un supermercado británico real de 1996. Una tienda sin marcas parece falsa con facilidad. Los envases en blanco parecen algo a lo que le han quitado información. Así que todos los envases del vídeo están impresos y tienen color, pero sin nada que se pueda leer.
El cliente lo aprobó, con un comentario:
«La familia parece triste ahora mismo (LOL), pero sé que no será así cuando esté ‘en acción’.»
Las expresiones eran intencionadas. Venían del estilo fotográfico que habíamos elegido.
La fotografía documental no pide a la gente que sonría a la cámara. Esto tenía que ser una fotografía neutra de una familia, no una familia feliz de banco de imágenes.
El modelo hacía exactamente lo que le pedíamos. Las expresiones y la vida llegarían después, en la generación de vídeo, cuando la familia empezara a moverse, hablar y reaccionar entre sí.
Fichas de personaje: una persona, muchos planos
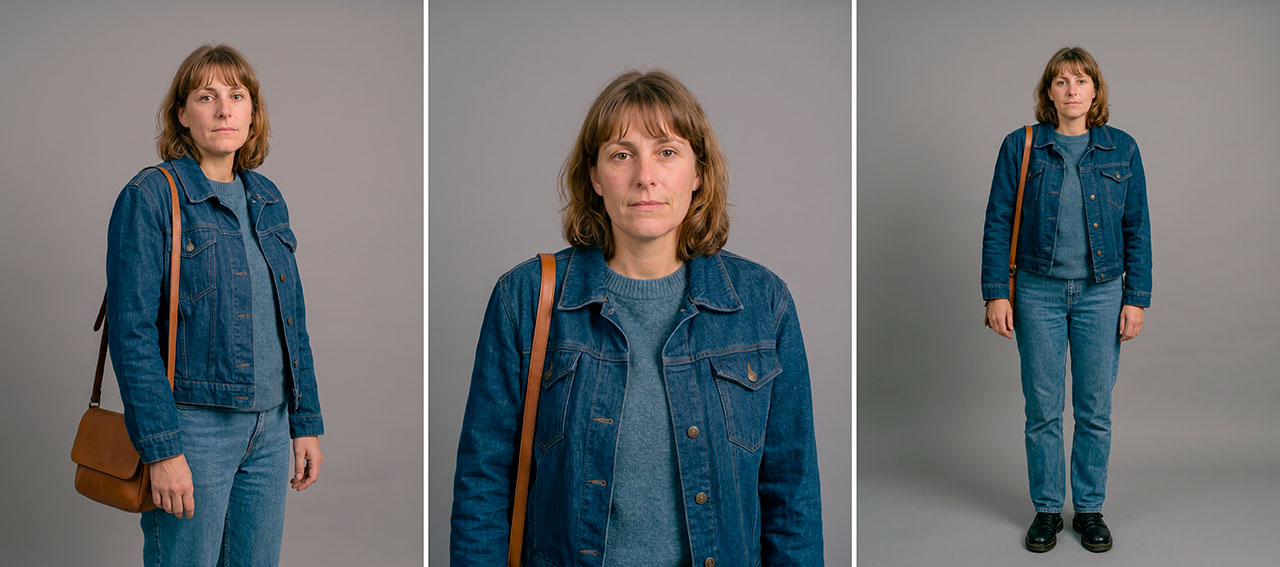
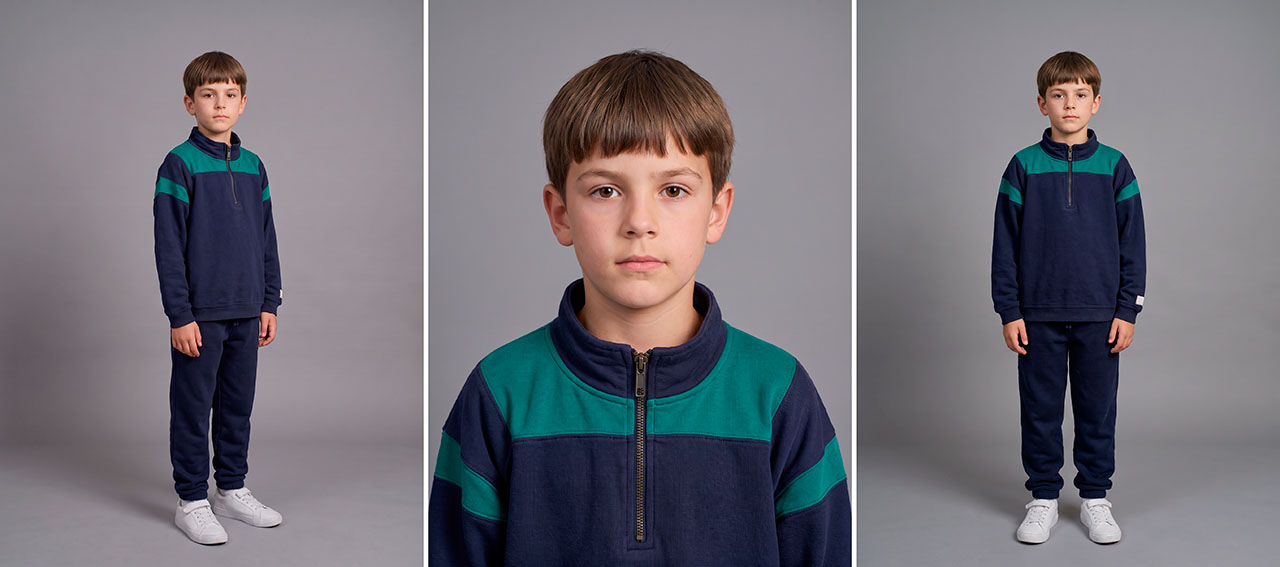
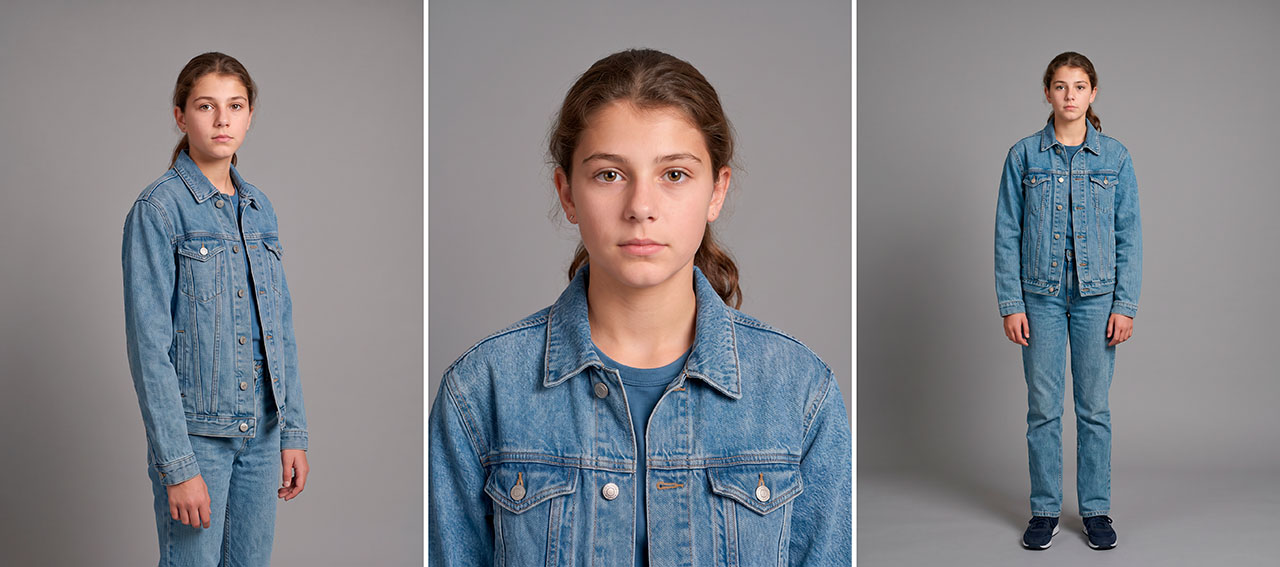
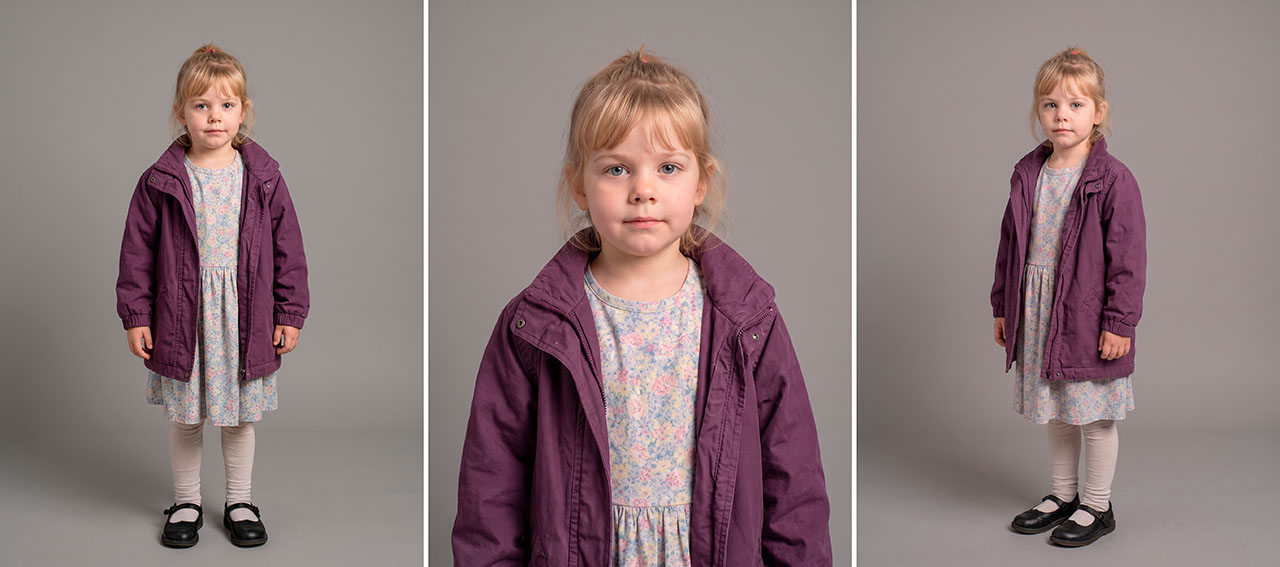
Cuatro personas aparecen en varios planos del acto de 1996. Los modelos de imagen no recuerdan a las personas de una generación a otra. Sin una referencia, la madre del plano 2 y la del plano 14 son dos mujeres distintas.
Así que creamos una ficha de personaje para cada uno, recortando a cada persona de la imagen de casting. Cada personaje tuvo tres imágenes a fotograma completo: cuerpo entero, plano americano y plano medio corto. Y fijamos cada prenda de ropa, porque a distancia es la ropa lo que hace reconocible a una persona.
Después, esas fichas entraron como referencia en cada fotograma y en cada clip.
Localizaciones
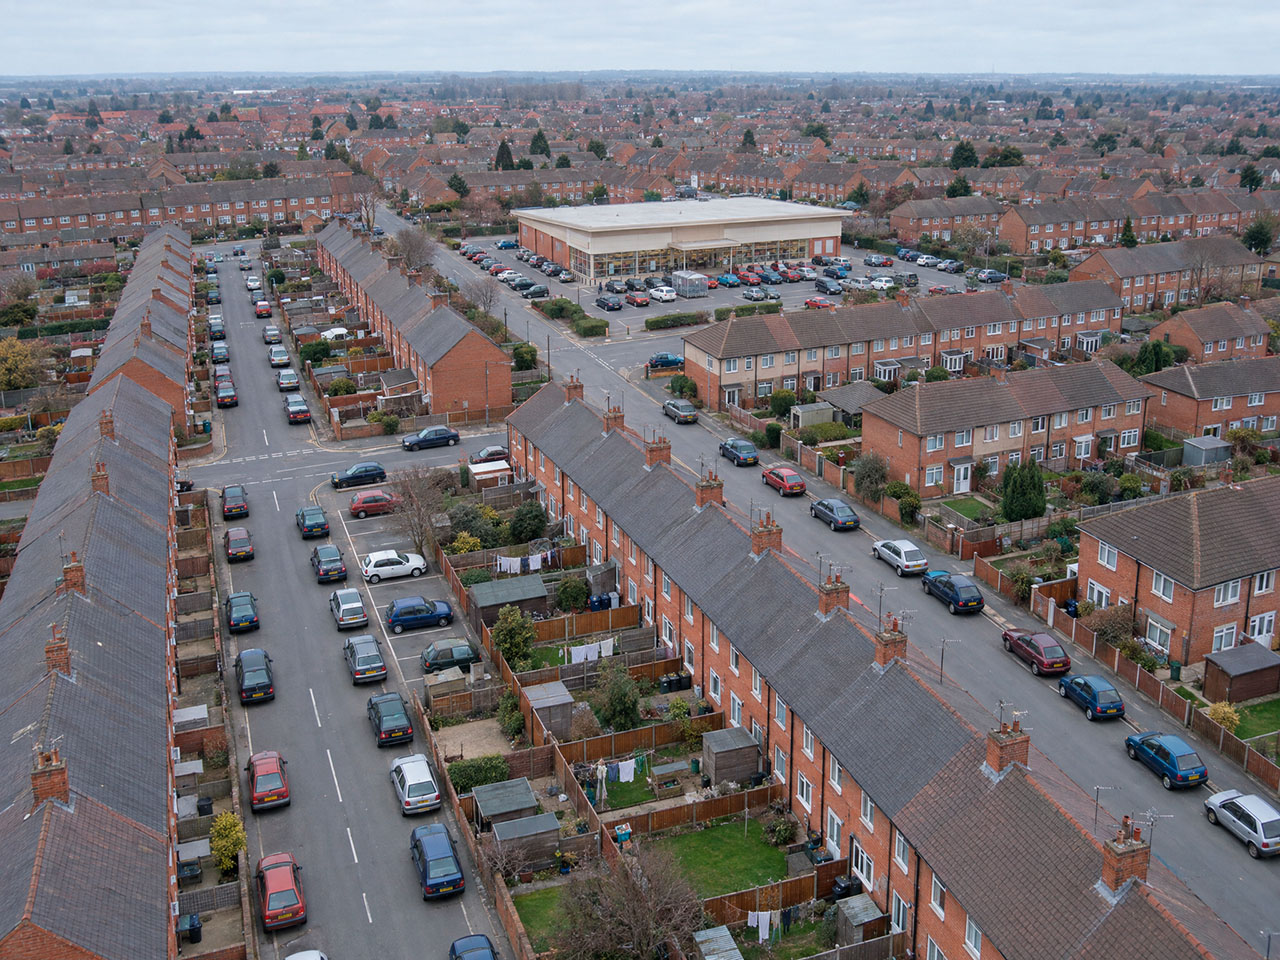
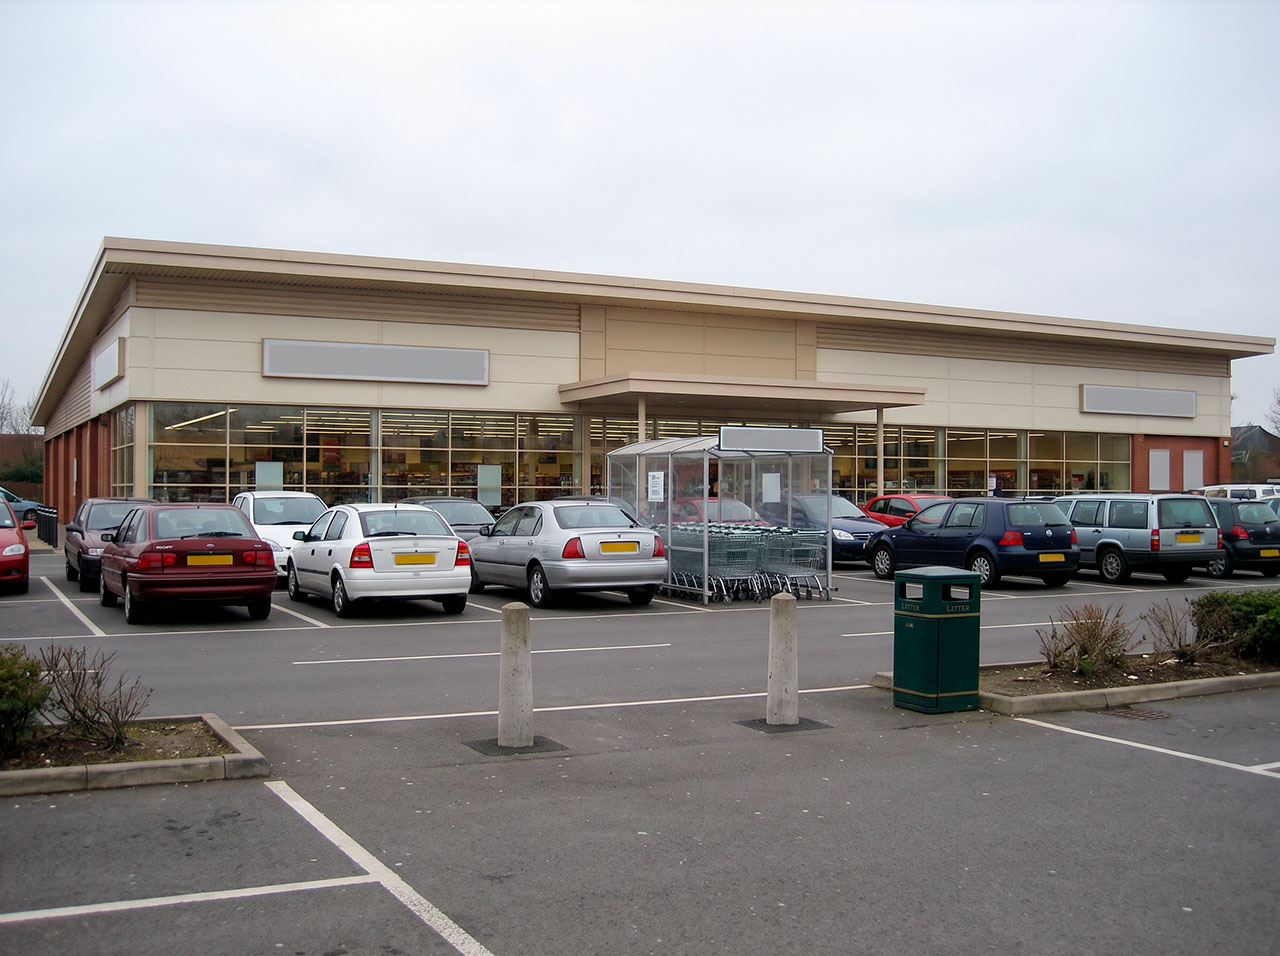
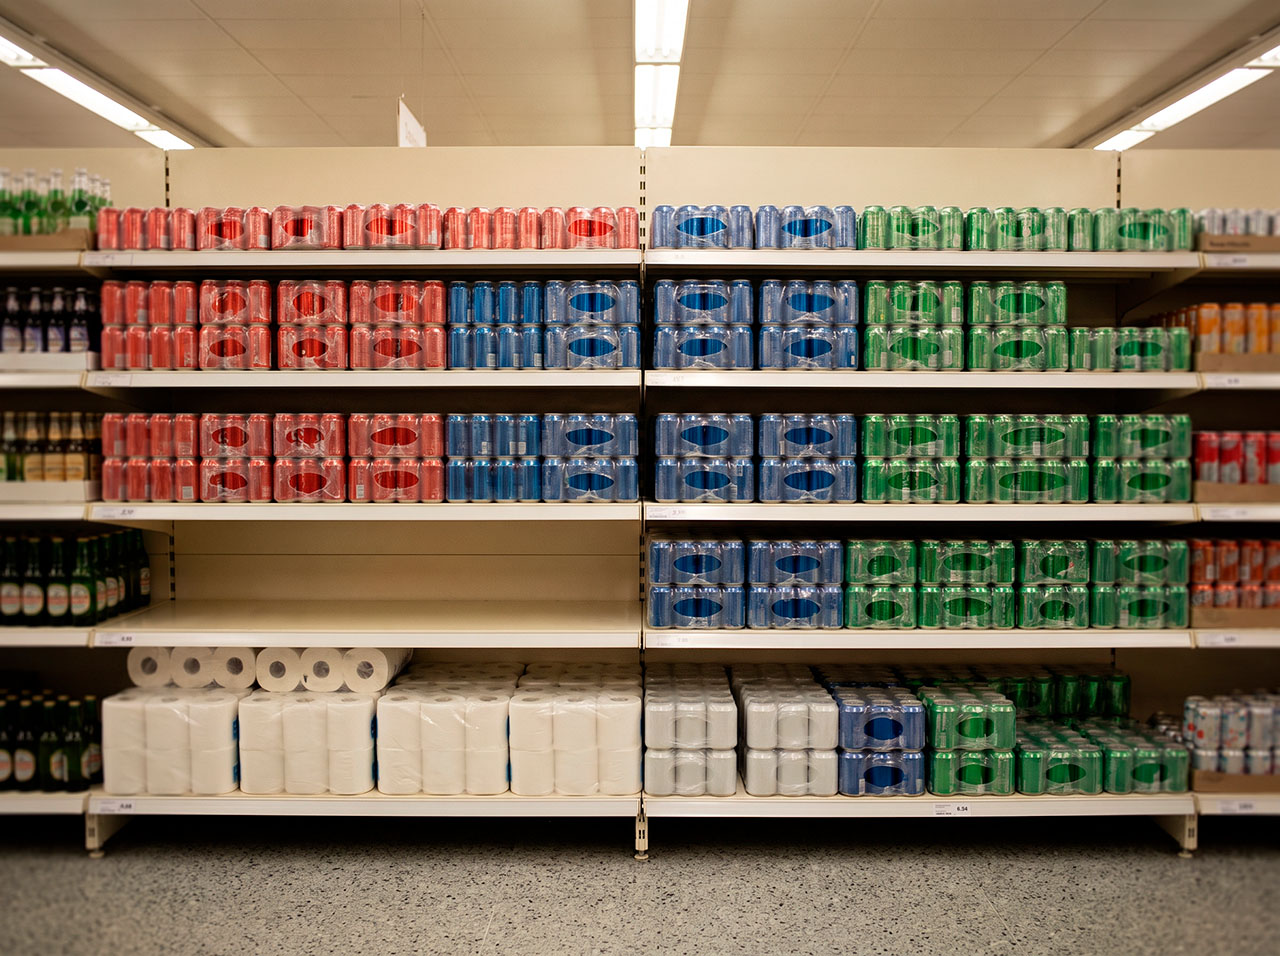
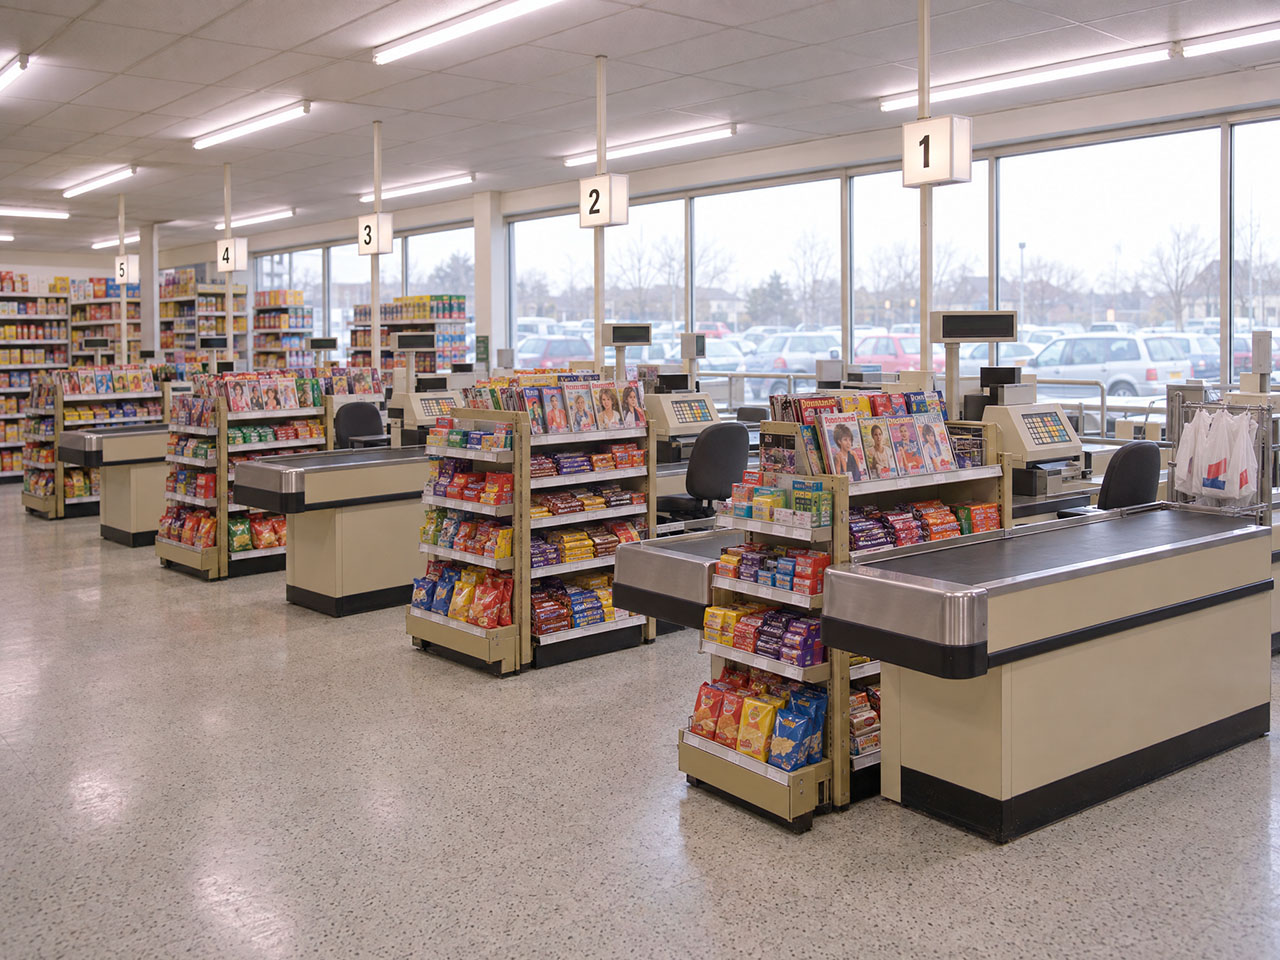
Hicimos lo mismo con los lugares. Creamos referencias reutilizables: el pasillo, las estanterías, las cajas, el aparcamiento, incluso el carro. Una referencia de localización lleva el estilo de un lugar: las estanterías, el suelo, la altura del techo, la calidad de la luz. Cada plano se construye sobre ella, así que todo el acto parece una sola tienda y no veinte.
El exterior necesitó más cuidado. Cuatro planos comparten el mismo edificio: el aéreo, la llegada, la entrada y la vuelta al coche. Generados por separado, son cuatro supermercados distintos.
El storyboard y el sonido
Con el reparto, los lugares y el estilo aprobados, generamos un fotograma para cada plano del acto de 1996. Esos fotogramas se convirtieron en el storyboard.
Enviamos el storyboard con algo más: la voz en off sobre cuatro músicas distintas.
El brief era concreto con el sonido. Pedía una voz británica cálida y segura, «conversacional y observadora, no una ‘voz de Dios’ ni comercial».
Generamos la voz en off en ElevenLabs on varias voces que encajaban con esa descripción. Una de ellas era la buena en cuanto la oímos.
Después elegimos cuatro temas de un banco de música, mezclamos cada uno con la voz y enviamos los cuatro. El cliente eligió uno enseguida, y se quedó hasta el final.
Las herramientas
Claude: de la idea al prompt
Claude fue la herramienta que más usamos en este vídeo. La investigación y el guion AV fueron parte de ello. Pero donde marcó más diferencia fue en los prompts.
Los modelos de imagen y de vídeo necesitan un lenguaje muy preciso. Un prompt para un fotograma tiene una estructura: la escena, las imágenes de referencia, la cámara, la luz, la captura y lo que hay que dejar fuera. Un prompt de vídeo es lo contrario: corto, con una acción, un movimiento de cámara y una nota sobre lo que debe mantenerse estable. Hacerlo bien en cada plano, y mantener la coherencia en cincuenta planos, es difícil.
Claude funcionó como traductor entre nuestras ideas y los prompts. Explicábamos lo que queríamos ver, con nuestras palabras. Claude escribía el prompt. Generábamos la imagen y le enseñábamos el resultado. A veces nos convencía la primera. Otras veces seguíamos iterando hasta conseguir lo que buscábamos. Después hacíamos lo mismo con los prompts de vídeo. Le dábamos a Claude el fotograma y le pedíamos el prompt de vídeo, describiendo lo que queríamos. No habríamos podido escribir prompts de este nivel por nuestra cuenta, y desde luego no con esta coherencia.
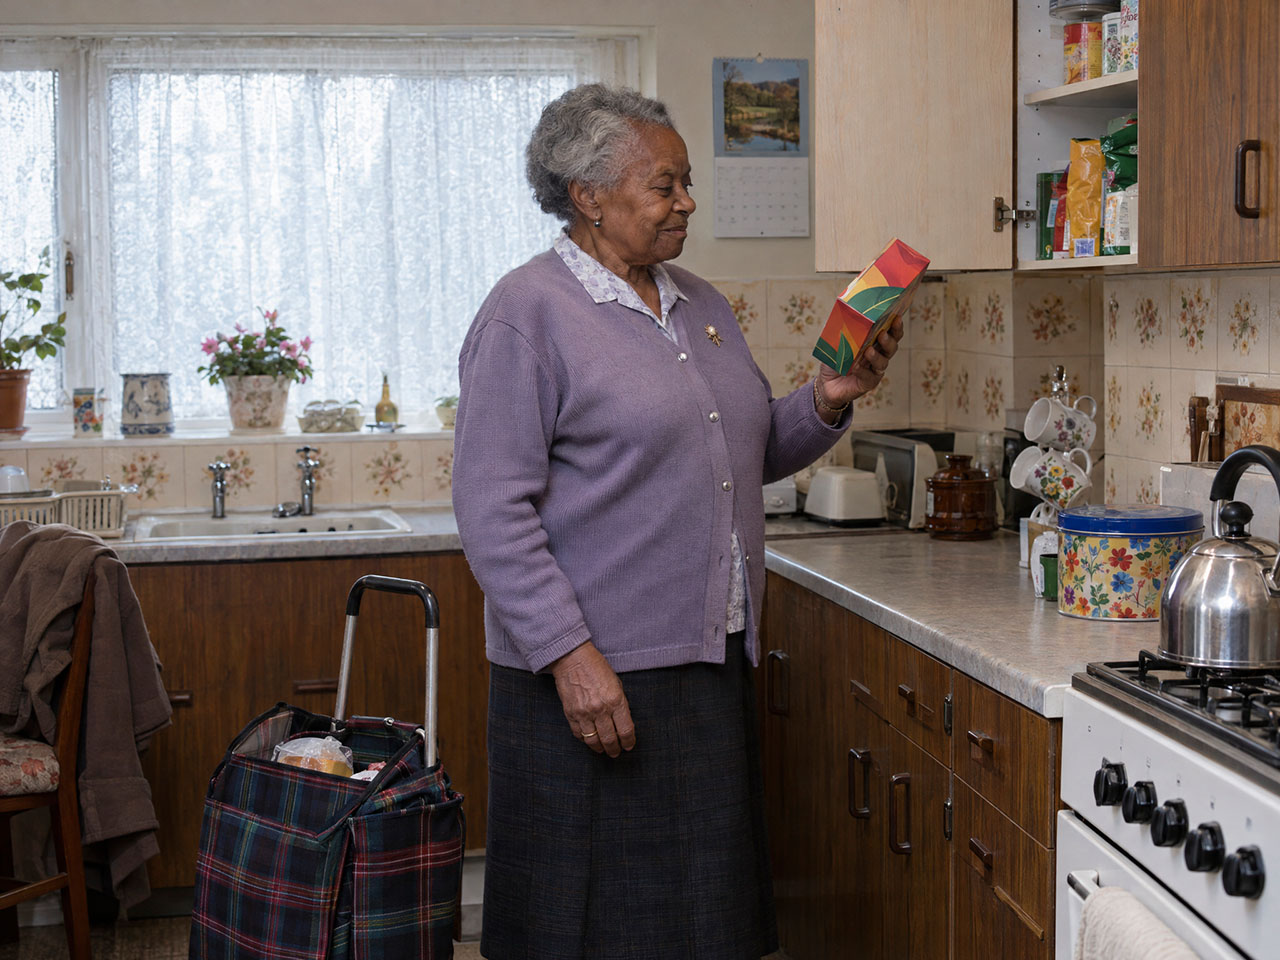
A documentary photograph in a British kitchen in 1996.
SCENE
A woman in her seventies stands at the kitchen worktop, facing towards the right of the frame. Beside her on the floor stands a two-wheeled tartan shopping trolley, its top open. She has just taken a box of tea out of the trolley and holds it in one hand, raised in front of her, looking at it with a small private pleased smile — her own tea, the thing she always buys.
Above the worktop to her right, one wall cupboard door stands open, its shelves visible inside, half full of tins and packets. She is about to put the tea away.
THE WOMAN
A black woman in her mid-seventies. Short grey hair, neatly set. A lined, ordinary face, no makeup, warm and unremarkable. Small build, slightly stooped. She wears a buttoned cardigan over a blouse and a skirt. A wedding ring and a small brooch. Her coat is hung over a chair behind her.
THE TROLLEY
A 1990s two-wheeled shopping trolley: a fabric bag in a dark tartan check on a metal frame with a long handle and two small wheels, standing upright on the kitchen floor, its top flap open with a few groceries still inside. No brand name, no wordmark, no logo.
THE TEA
A plain rectangular cardboard box of tea bags in a simple flat colour, with an invented generic design and no readable text or logo.
THE FRAMING
Seen from the side. The kitchen worktop runs along the right of the frame, against the wall, with the wall units above it and one cupboard door open. The woman stands in the middle of the frame, facing right. The shopping trolley stands on the floor beside her, towards the left. Nothing stands between the camera and the woman — no island, no peninsula, no table.
THE KITCHEN
A small older British kitchen: dark wood-effect units with plain handles, a worn laminate worktop, a ceramic sink under a window with patterned net curtains, floral wall tiles, a whistling kettle on a gas hob, a biscuit tin, a calendar on the wall with no readable print. Tidy and dated, warm and well kept.
CAMERA
Chest height, square on to the side of the kitchen. Medium full shot — the woman is framed from just above the knees upwards, with headroom above her, and the top of the shopping trolley visible at the bottom of frame. She is positioned in the middle of the frame, with the worktop and units to her right. Handheld, slightly off-centre, unremarkable framing.
LIGHT
Soft grey daylight from the kitchen window, plus a domestic ceiling light. Flat, even, no direct sun, no strong shadows. Neutral and slightly cool, not warm and not golden. Her face is clearly lit and readable.
CAPTURE
Clean modern digital capture. Sharp, correctly exposed, neutral colour. No film grain, no VHS artefacts, no date stamp, no vignette, no colour filter.
PACKAGING
All packaging is printed and colourful in saturated varied colours — not blank, not white, not plain. Every design is invented and generic. There is no readable text, no wordmark and no logo anywhere.
DO NOT INCLUDE
A full length shot showing her feet or the floor beneath her. A closed cupboard — one door stands open. A modern four-wheeled shopping trolley or a wheeled suitcase. Any brand name, wordmark or logo on the trolley or the tea. A kitchen island, a peninsula, a breakfast bar or a table between the camera and the woman. A modern kitchen, modern appliances, granite or quartz worktops, an induction hob. Any readable text, wordmark or logo. Anyone looking at the camera. Broad advertising smiles. An American kitchen. Warm golden light.
The woman looks at the box of tea in her hand for a moment with a small, private smile. Then she reaches up, places it on the shelf inside the open cupboard, and closes the cupboard door gently with the same hand. Calm, unhurried movements.
Static camera.
The box keeps its design. Her face and clothing stay consistent. The cupboard and its contents keep their shape.
@Girl is the small girl in the purple coat. @Teenager is the teenage girl in the light denim jacket. @Boy is the boy in the navy and teal sweatshirt.
The family walks across the car park from left to right, heading back to the car. The mother pushes the trolley full of white carrier bags, looking ahead with a small smile, in her own thoughts. @Boy chats animatedly to his sisters, gesturing. @Teenager and @Girl walk hand in hand, smiling and listening to him. Relaxed and in a good mood.
The camera tracks from left to right alongside them, keeping them in the same position in frame.
The trolley stays full of plain white bags. The parked cars stay still.
Crane shot: the camera descends slowly and smoothly towards street level.
A plain white 1990s panel van — boxy, with a rounded front and no markings — enters the frame from the bottom and drives steadily up the road away from the camera, keeping to the left side of the road, and carries on into the distance.
The people on the pavements carry on walking. The cars in the distance keep driving up and down the road.
The parked cars stay parked and do not move. The houses, walls and gardens stay unchanged. No text or logo on the van.
The woman walks along the pavement from left to right at a steady, ordinary walking pace, carrying the two white carrier bags, which swing slightly with her steps. She looks ahead.
The camera tracks from left to right alongside her at the same speed, keeping her in the same position in frame. The houses and walls slide past behind her.
The bags stay plain white. Her face and clothing stay consistent.
La otra gran ventaja fue la memoria. Dentro de un chat, Claude tenía presente todo lo que habíamos decidido: los nombres de los personajes, su ropa, las localizaciones, las reglas que habíamos aprendido, cada error y cómo lo resolvimos. Cuando descubrimos que nombrar un color hacía que el modelo de imagen lo exagerara, esa regla entró en todos los prompts siguientes.
Modelos de imagen y de vídeo
La imagen de casting se hizo con GPT Image 2 en Magnific.
Para las fichas de personaje pasamos a Nano Banana Pro, que mantenía mejor la coherencia de las caras.
Después, a mitad de proyecto, apareció GPT Image 2.5 en Magnific. Había salido diez días antes y prometía más coherencia con las imágenes de referencia. Sobre el papel, cambiar de modelo en mitad de una producción era mala idea, y Claude nos lo desaconsejó. Aun así lo probamos, con nuestros propios fotogramas.
El consejo era equivocado. GPT Image 2.5 ganó con claridad. Clavó el estilo fotográfico que buscábamos. Sus imágenes parecían fotografías reales, más cerca del realismo que queríamos. A su lado, Nano Banana Pro parecía plano y algo artificial. Cambiamos para el resto del vídeo.
La lección es práctica. Estas herramientas cambian cada pocas semanas. Un consejo que vale el lunes puede estar equivocado el viernes. Prueba distintos modelos con tu propio material y quédate con el que te dé lo que buscas.
Para el vídeo, la mayoría de los planos se generaron en Kling 3.0, usando el fotograma aprobado como primer fotograma y las fichas de personaje para mantener estables las caras. Para los primeros planos de objetos, como la moneda entrando en el carro o la rueda girando, MiniMax H3 dio mejores resultados. Cuando un clip terminaba unos fotogramas antes de tiempo, lo alargamos con Seedance 2.5.
Magnific Spaces
La mayor parte del trabajo se hizo dentro de Magnific, en Magnific Spaces. Spaces es un espacio de trabajo visual basado en nodos para la producción con IA. Está a medio camino entre ComfyUI, un lienzo infinito para moodboards y un pipeline de producción, pero es mucho más fácil de usar.
Lo que más valoramos es que ves todo el proyecto en un solo tablero, paso a paso, con una estructura clara. Empiezas con un lienzo en blanco. En este proyecto, lo primero fue la imagen de casting aprobada. Todo lo demás se construyó a partir de ahí, conectando herramientas mediante nodos: nodos de texto, generadores de imagen, generadores de vídeo, escaladores y editores de imagen.
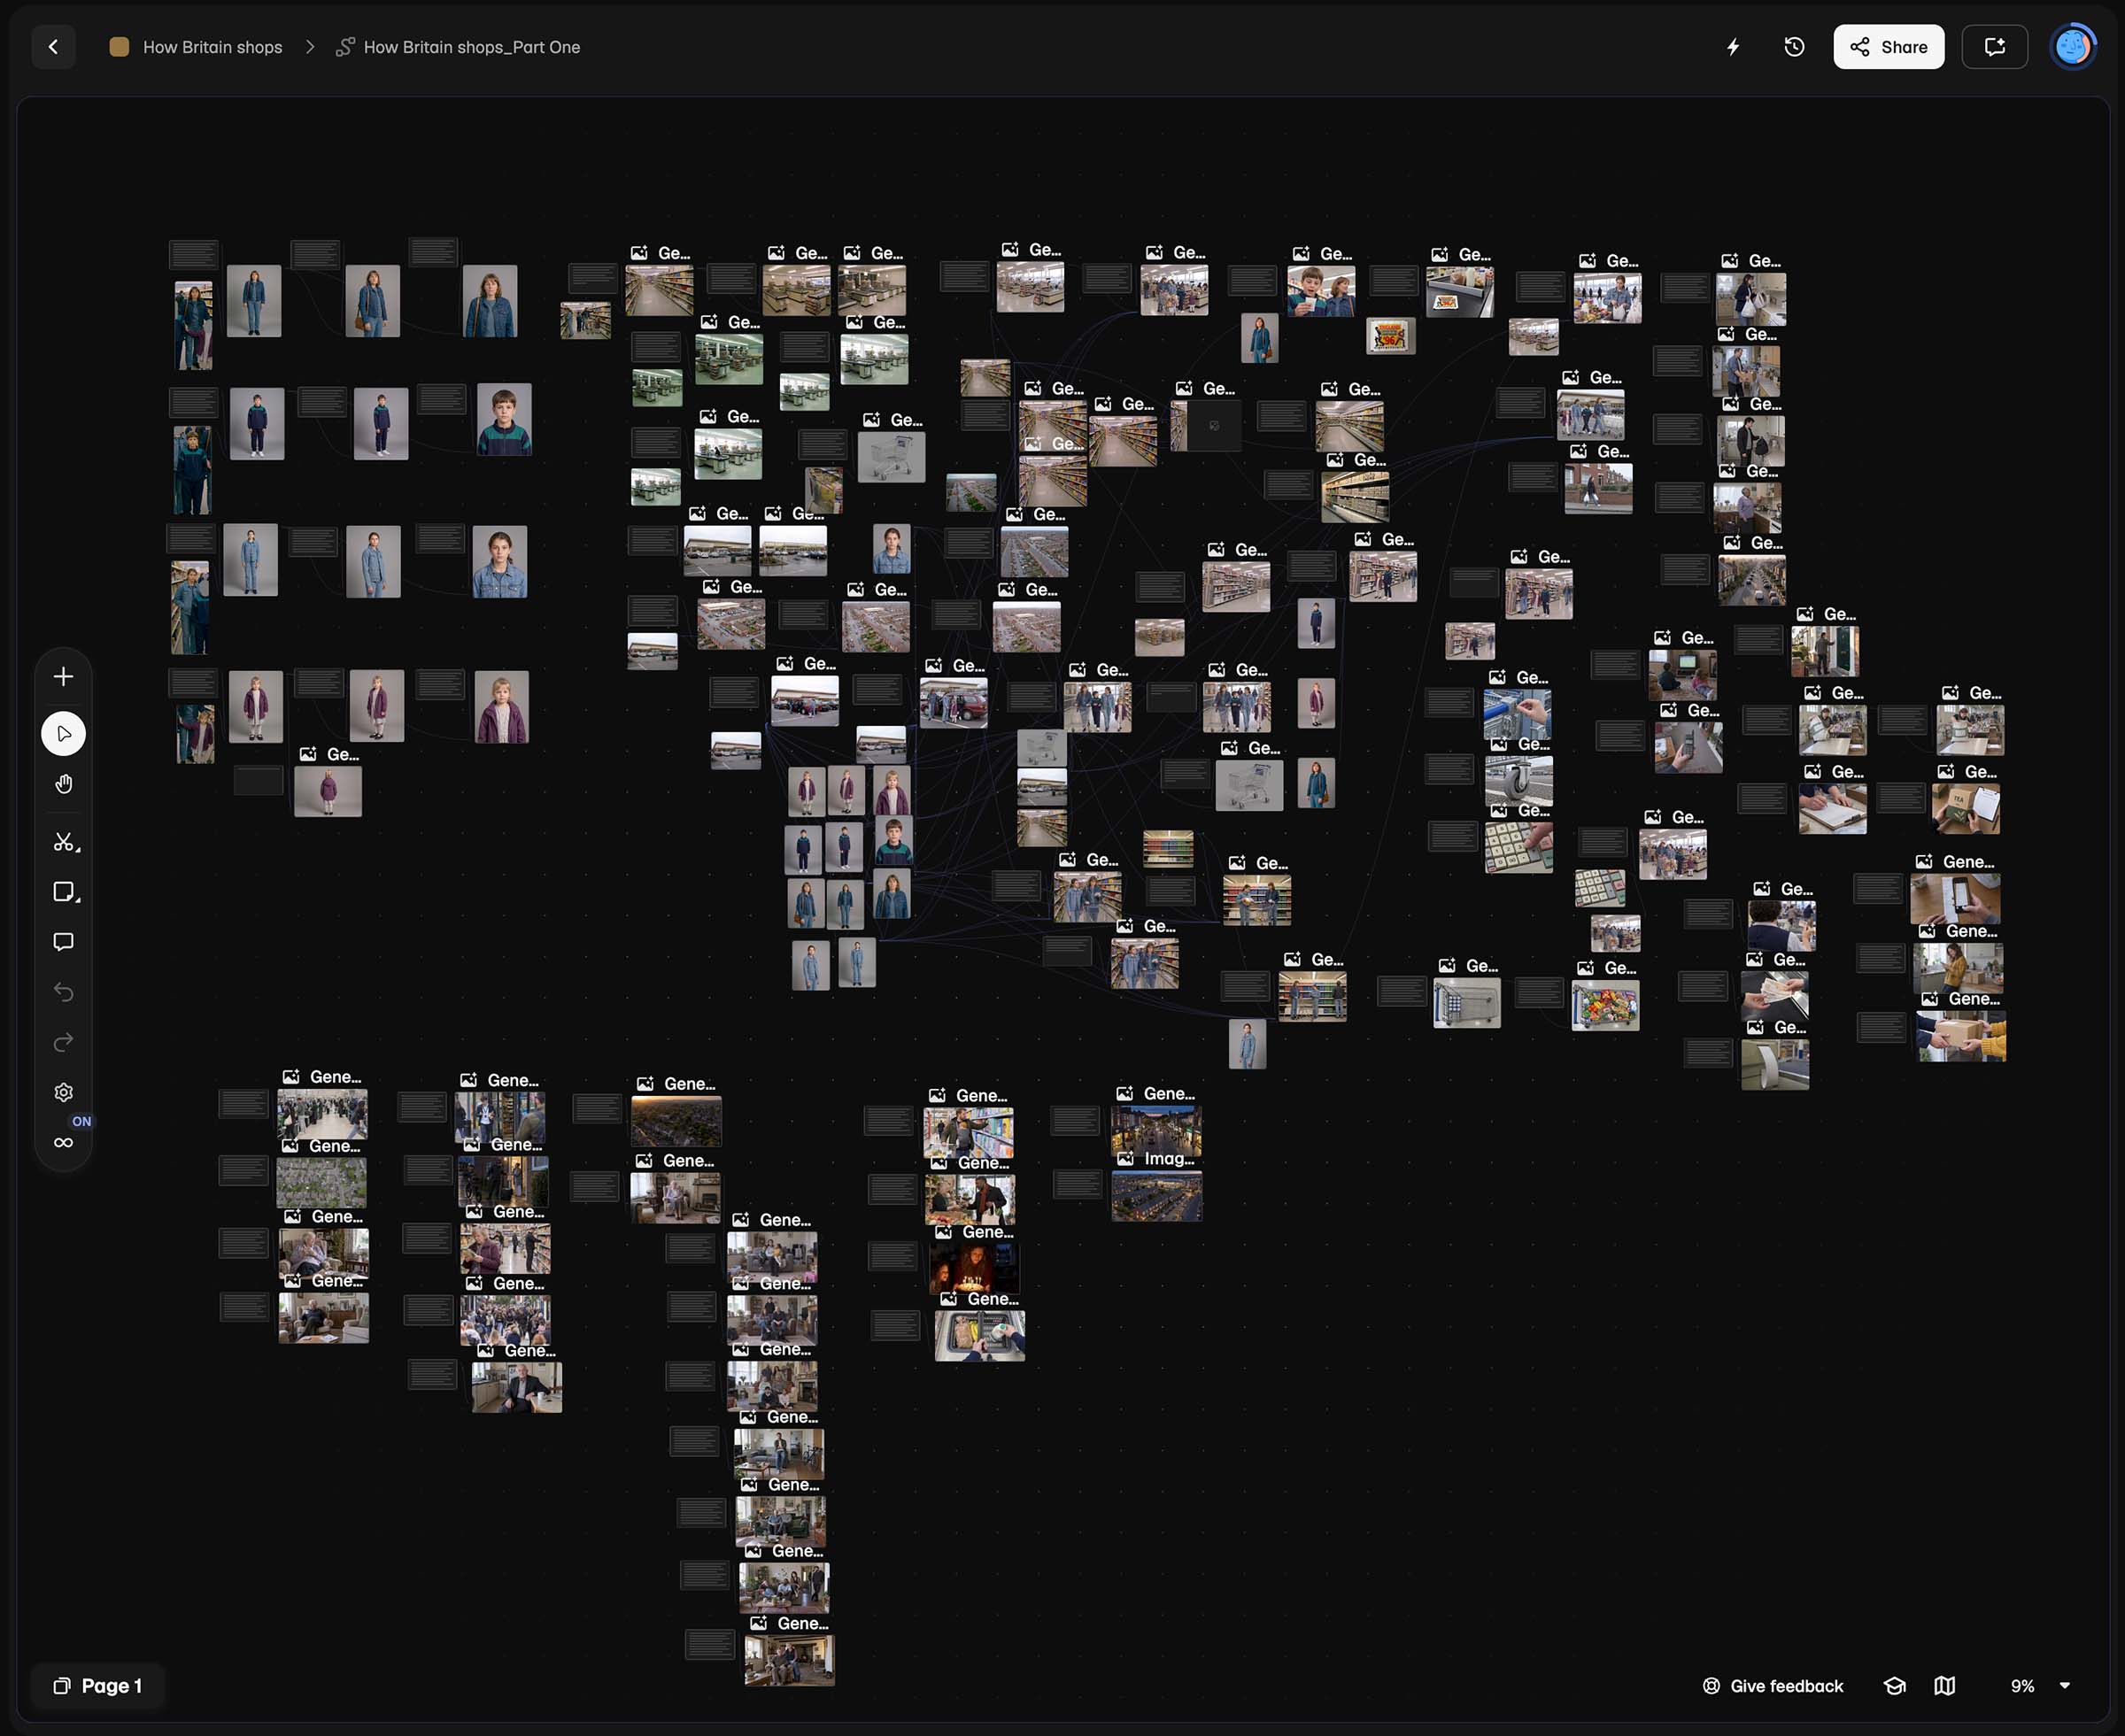
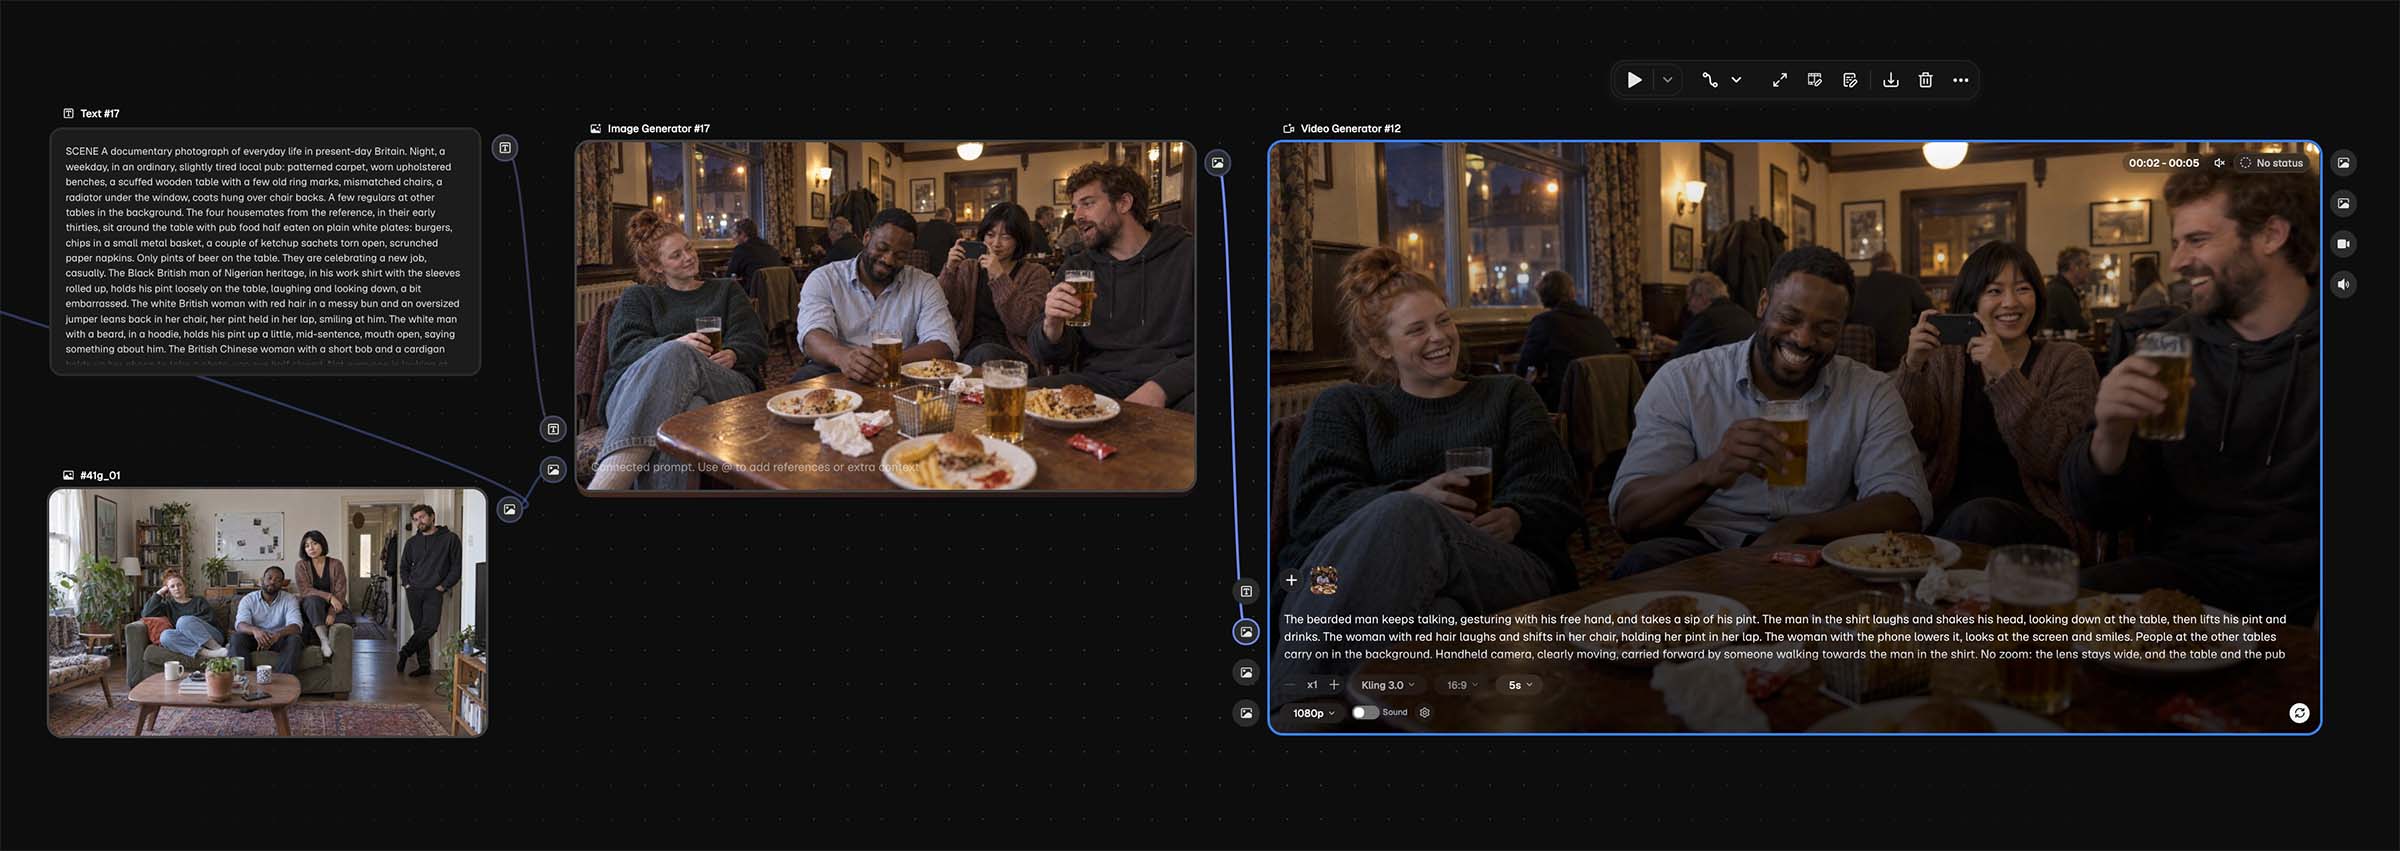
Un plano típico funcionaba así. Un nodo de texto contenía el prompt. Estaba conectado a un generador de imagen, que a su vez estaba conectado a las imágenes de referencia: las fichas de personaje y las referencias de localización. Juntos producían el fotograma. Si algo no estaba bien, manteníamos la misma estructura y cambiábamos solo lo necesario: el prompt, el modelo o las referencias. Y volvíamos a generar hasta que la imagen era la buena.
Para el vídeo, conectábamos ese fotograma a un generador de vídeo como fotograma inicial y añadíamos el prompt de vídeo.
Todo el camino hasta cada clip se queda en el tablero. Semanas después, podíamos volver a cualquier plano y cambiar cualquier cosa en cualquier fase, sin rehacerlo desde cero. Cuando el cliente pedía un cambio, sabíamos exactamente dónde hacerlo.
Lo que nos enseñó 1996
Generar un vídeo no es lo mismo que generar una imagen. Estas reglas salieron del acto de 1996, casi todas aprendidas a base de errores.
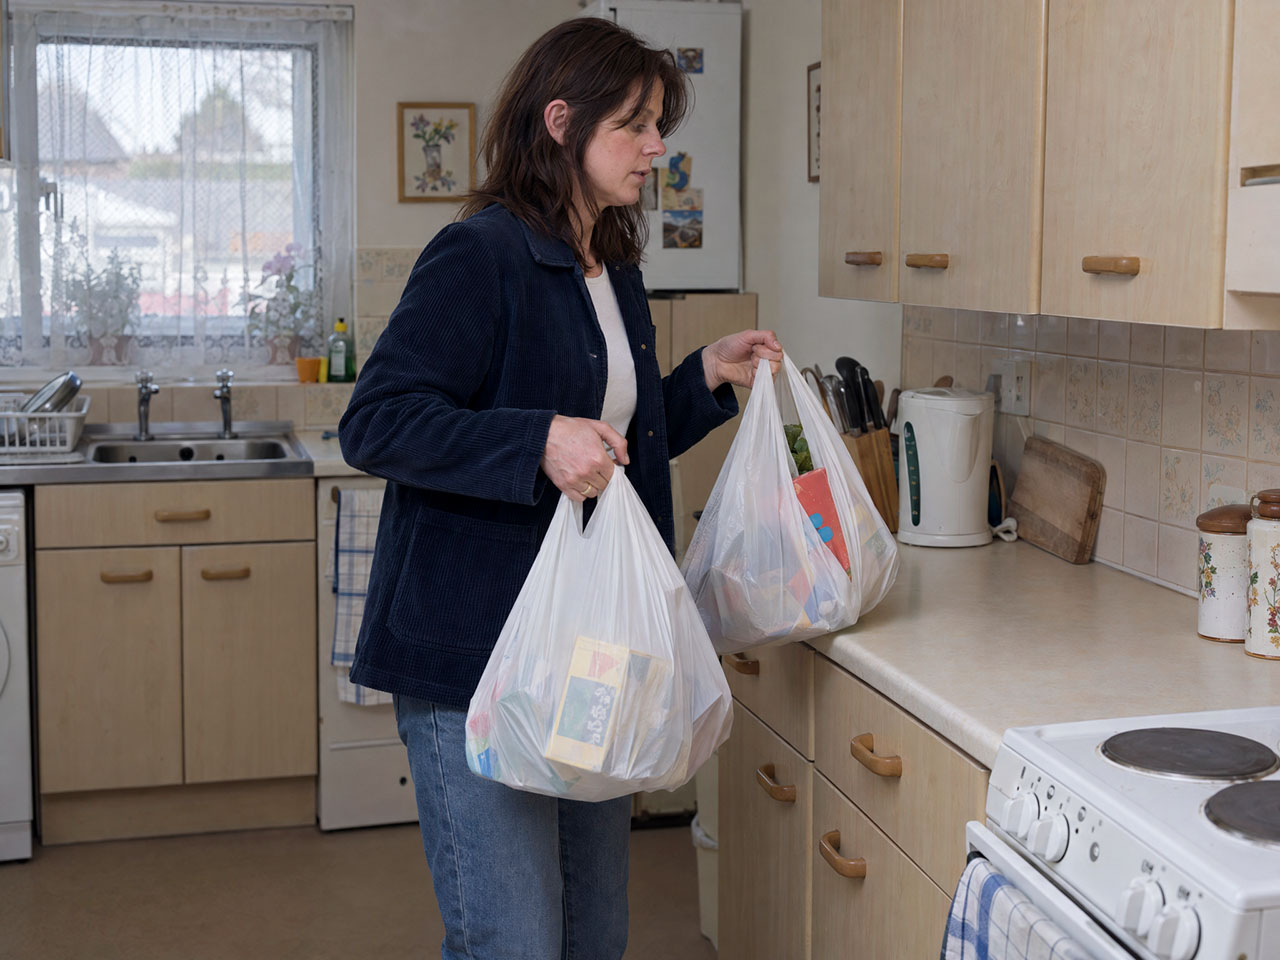
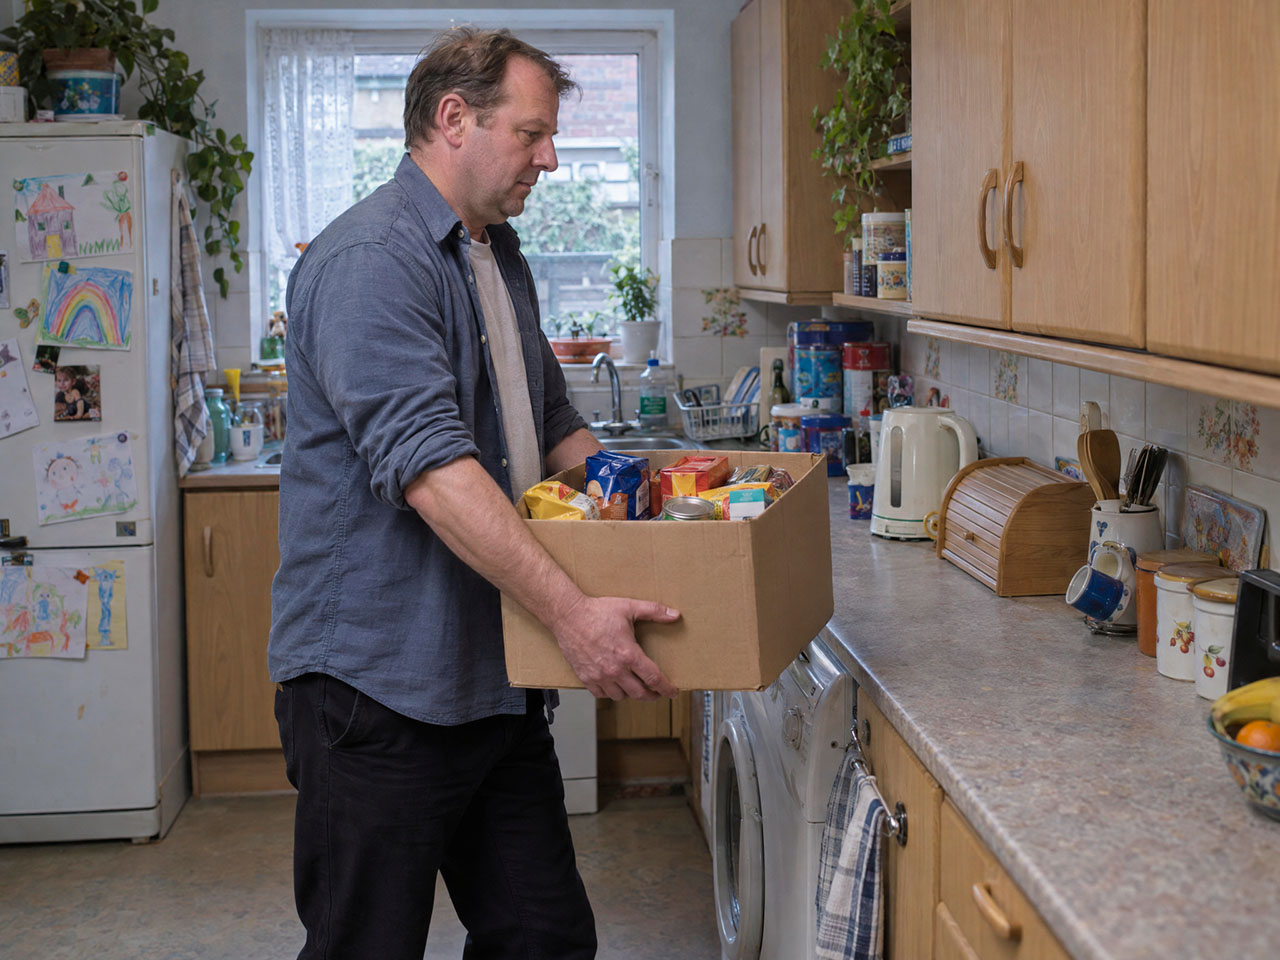
Un momento por fotograma. Un fotograma solo puede contener un instante. Todo lo que necesita tiempo va en el prompt de vídeo. A menudo diseñábamos el fotograma pensando hacia atrás desde el clip. Para un hombre que sube bolsas de la compra a la encimera de la cocina, elegimos el momento a mitad de camino: brazos doblados, bolsas a la altura de la cadera. Eso le da al modelo de vídeo un movimiento que completar.
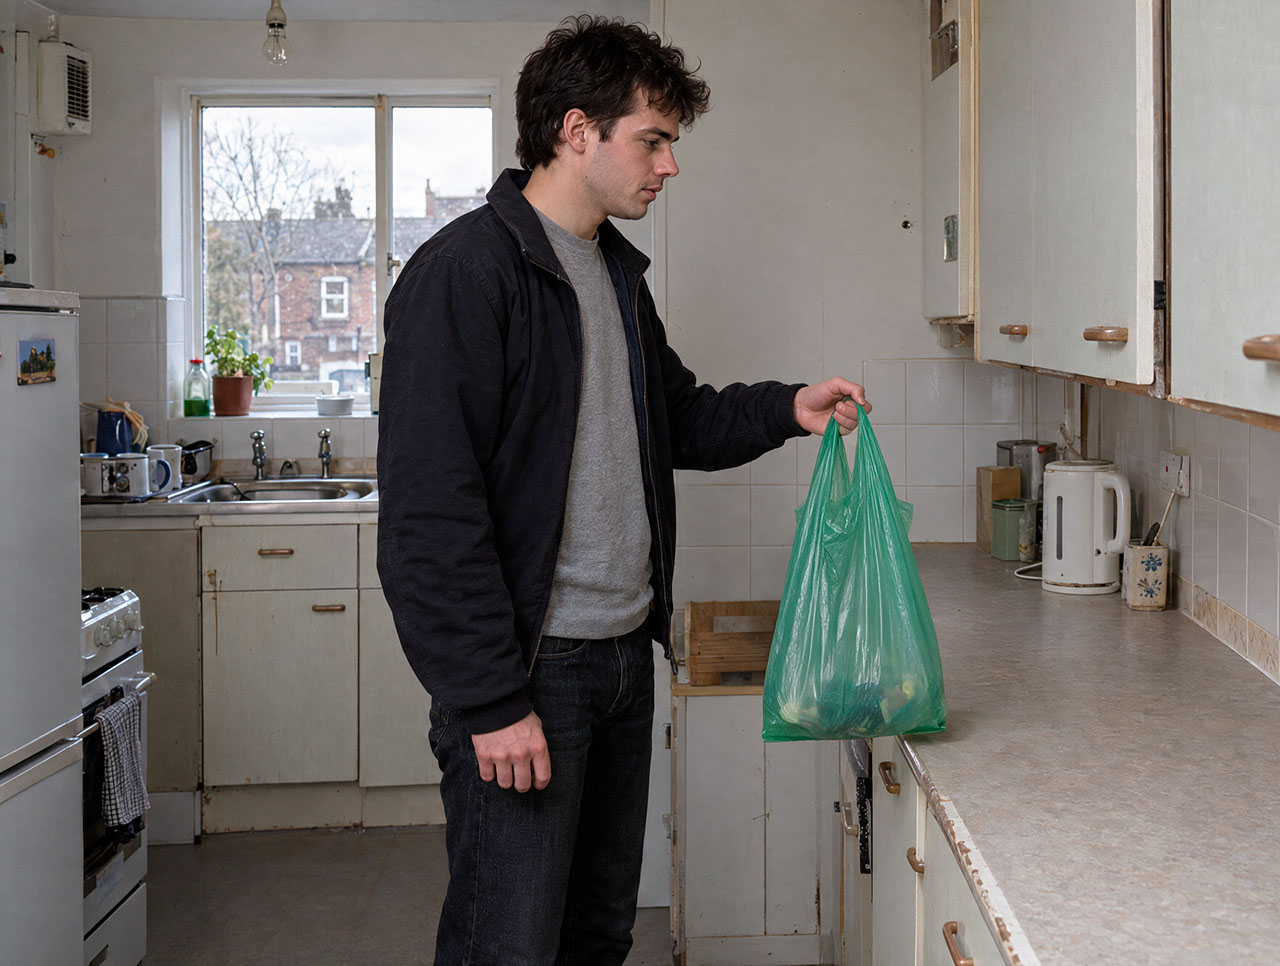
Describe comportamientos, no emociones. Pide «feliz» y obtendrás caras de anuncio, todos sonriendo a la vez. Así que dejamos de describir sentimientos y describimos lo que hace la gente. El niño está hablando. La adolescente sonríe por lo que dice. La niña pequeña mira otra cosa. Nunca todos al mismo nivel.
Describe la luz, no el color. Una vez pedimos una zona de cajas con «un ligero tono verde». Salió verde intenso. Cuando nombras un color, el modelo lo exagera. Describe de dónde viene la luz y lo dura que es, y deja que la imagen de referencia lleve el color.
Detecta todo en la fase de fotograma. Las marcas se cuelan todo el tiempo: un pack de refrescos de cola en las manos de la madre, cajas de películas en el suelo del salón, logotipos en un televisor. En un fotograma lo arreglas en minutos. En un clip no hay arreglo parcial. Tiras el clip entero.
Mantén limpios los fotogramas. La época está en la ropa, los coches, la caja registradora y los envases, no en la calidad de imagen. La textura VHS y el grano se añadieron en el montaje. Si pones grano en un fotograma de origen, el modelo de vídeo intenta animarlo.
Saber cuándo parar. Los billetes del plano del pago en efectivo nunca acabaron de parecer británicos a ojos británicos. Con los dedos encima, algo desenfocados y un segundo en pantalla, pasan. Diez generaciones más no habrían mejorado el vídeo.
El primer montaje
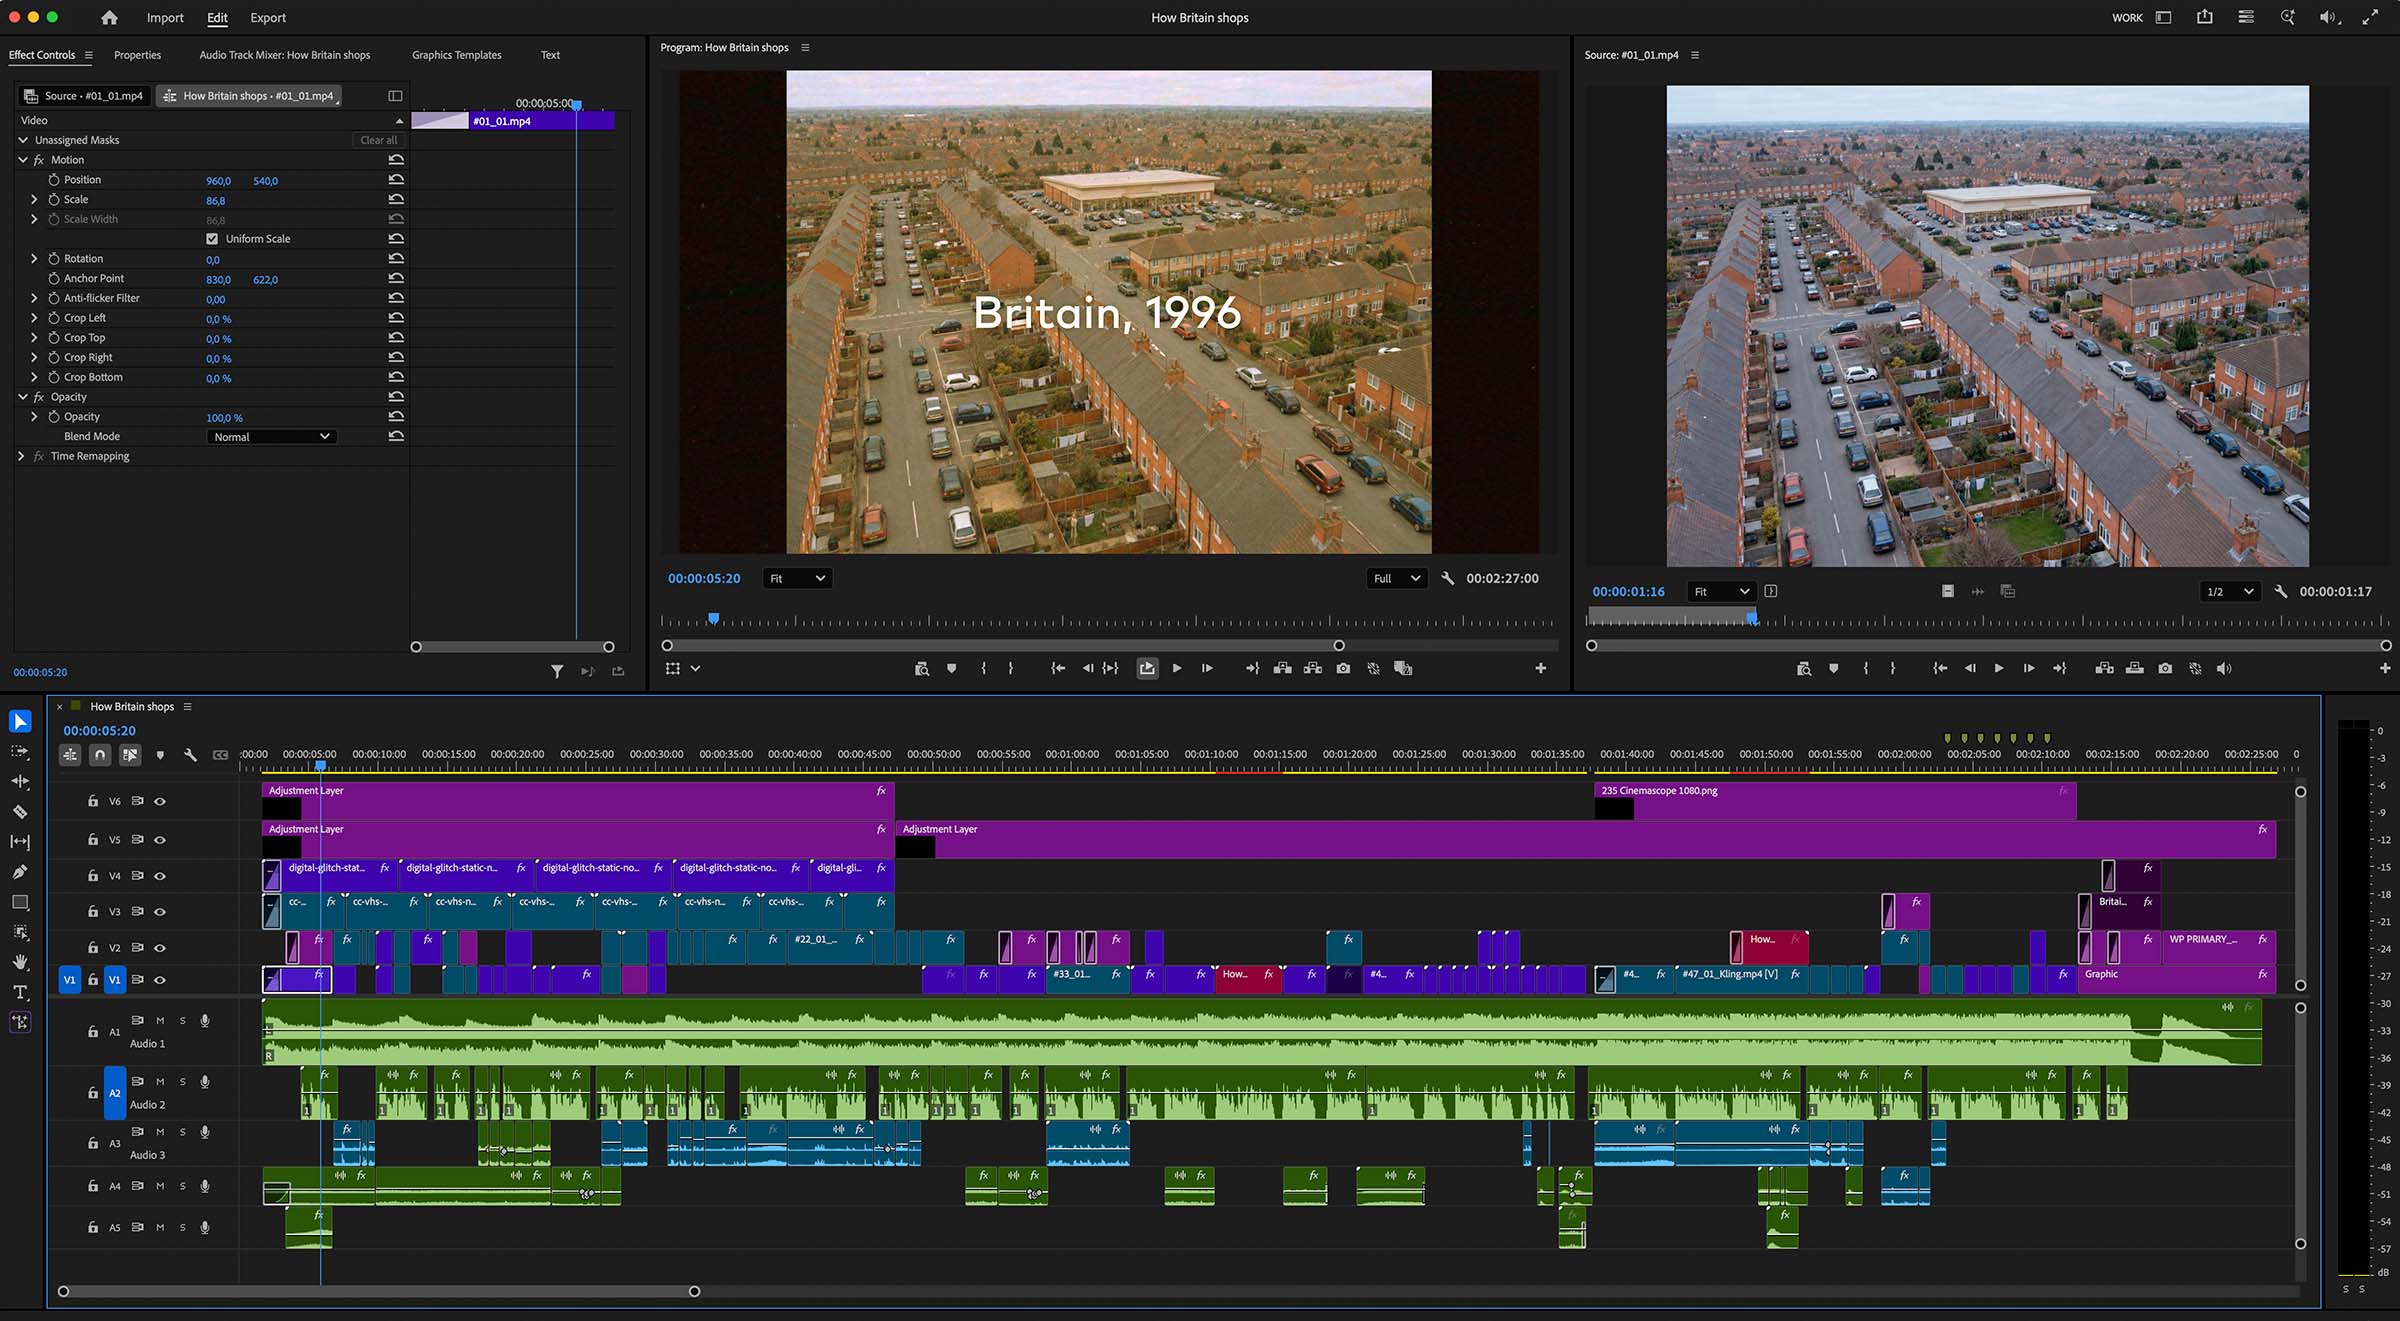
Todos los clips del acto de 1996 se generaron con IA. Pero el vídeo en sí se hizo donde siempre se han hecho los vídeos: en un timeline, en Adobe Premiere Pro.
Los clips generados son material en bruto. El diseño de sonido hizo gran parte del trabajo que pedía el brief: las ruedas del carro, las teclas de la caja, la impresora del tique. Esos sonidos transmiten la época por sí solos. Algunos planos del storyboard no entraron, simplemente por duración. Eso es montaje, y ningún modelo lo hace por ti.
Enviamos al cliente el primer acto por separado. Le encantó.
¿Por qué parar ahí?
El plan era volver al stock y a la IA para el resto del vídeo. Pero cuando puedes hacer exactamente la imagen que tienes en la cabeza, volver a lo que un banco de imágenes tenga a mano cuesta. Así que hicimos también el resto del vídeo con IA.
Un vídeo que transcurre en Gran Bretaña
Algo que nos encantó de las imágenes generadas fue lo británicas que eran. Este vídeo era para un público británico, en Londres, sobre cómo compra Gran Bretaña. Tenía que ser fiel a cómo es Gran Bretaña de verdad.
El stock casi nunca lo es. La mayoría es genérico, y mucho ni siquiera es británico. Aquí podíamos pedir exactamente lo que necesitábamos: calles de casas adosadas que dan paso a casas pareadas, un meal deal (sándwich, bebida y snack) de una tienda de conveniencia, un ramo de flores de gasolinera, un pub de barrio con moqueta estampada. El vídeo final es todo lo británico que podía ser. Con stock no lo habríamos conseguido.
El ejemplo más claro es una secuencia de ocho retratos de hogares, bajo la frase «El total es solo el titular. Lo que importa es la composición que hay debajo».
Una mujer de setenta y tantos años que vive sola. Una madre sola con dos hijos. Tres generaciones de una familia. Cuatro adultos que comparten casa. Cada hogar posa en casa, mirando directamente a cámara.
No son la idea de familia de un banco de imágenes. Son los tipos de hogar que forman de verdad la Gran Bretaña de hoy, fotografiados en casa como lo haría un fotógrafo documental. También hicimos el casting para reflejar la diversidad real de la población británica: ni uniforme, ni tan variada que parezca un ejercicio de casting.
El encuadre nunca cambia: misma óptica, misma altura, misma distancia, misma luz. Solo cambia el hogar. Esa igualdad es lo que hace que se lea como el retrato de un país, y no como un montaje de casas distintas.
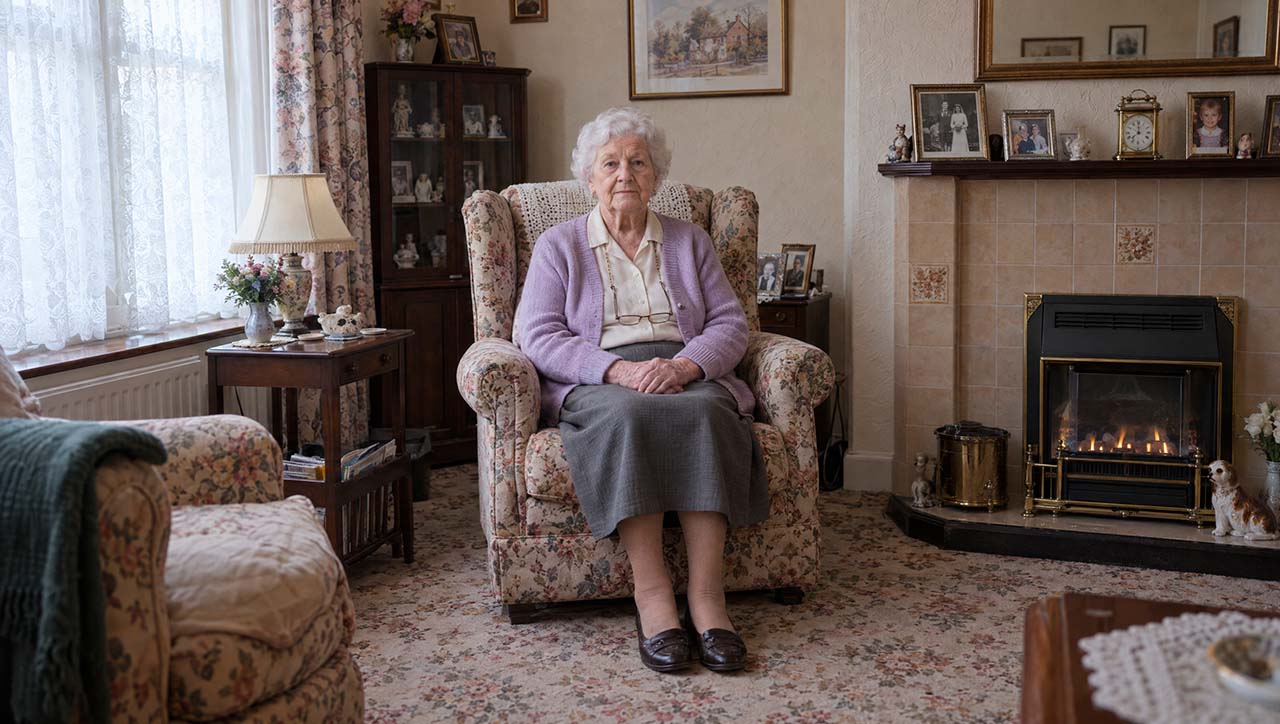
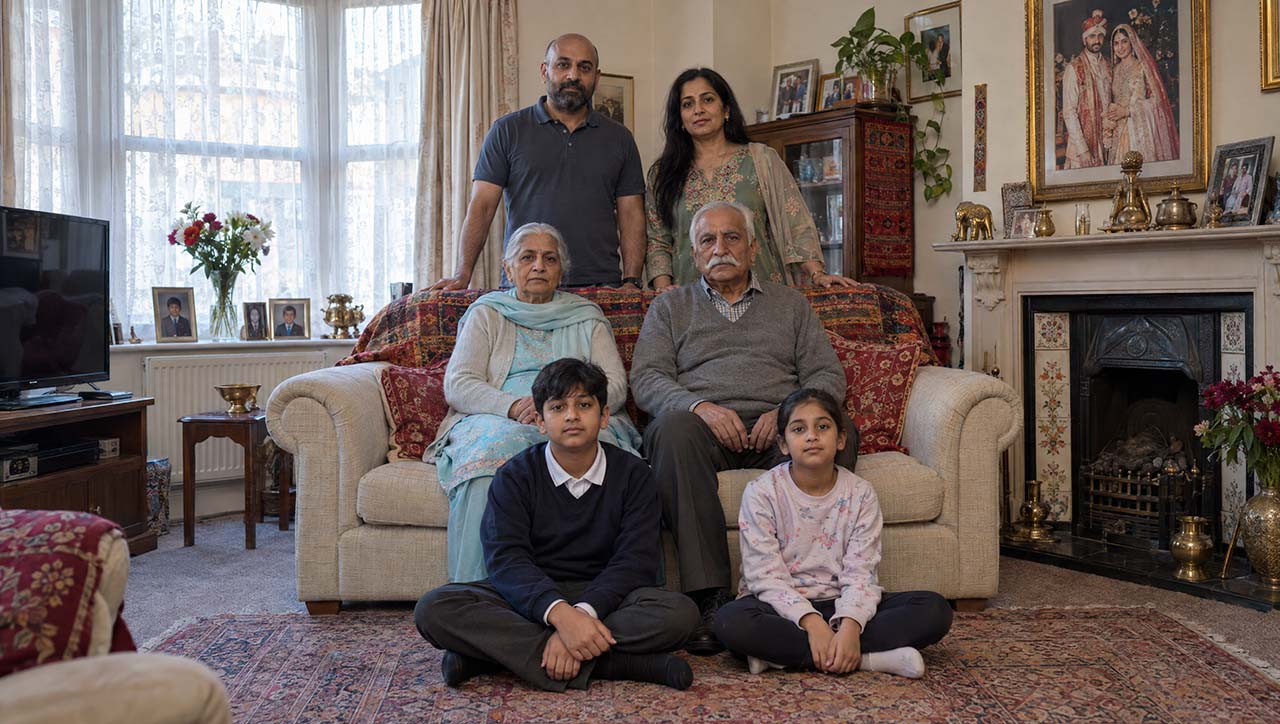
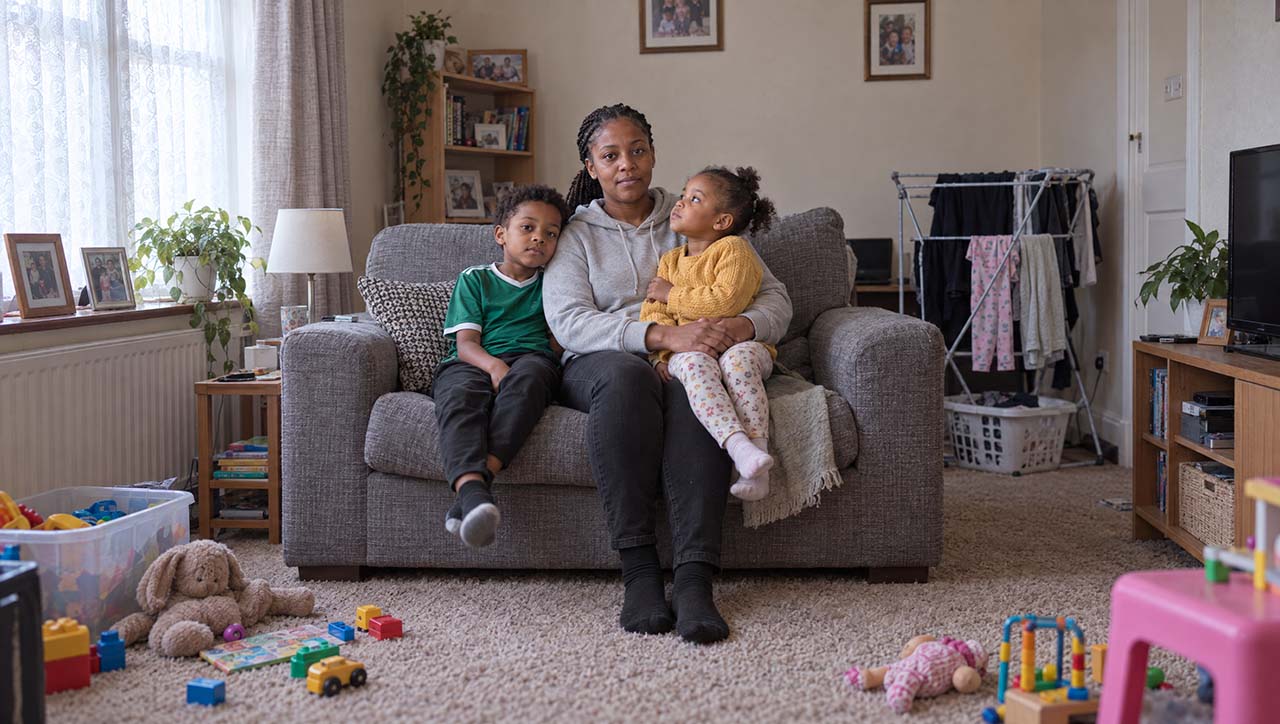
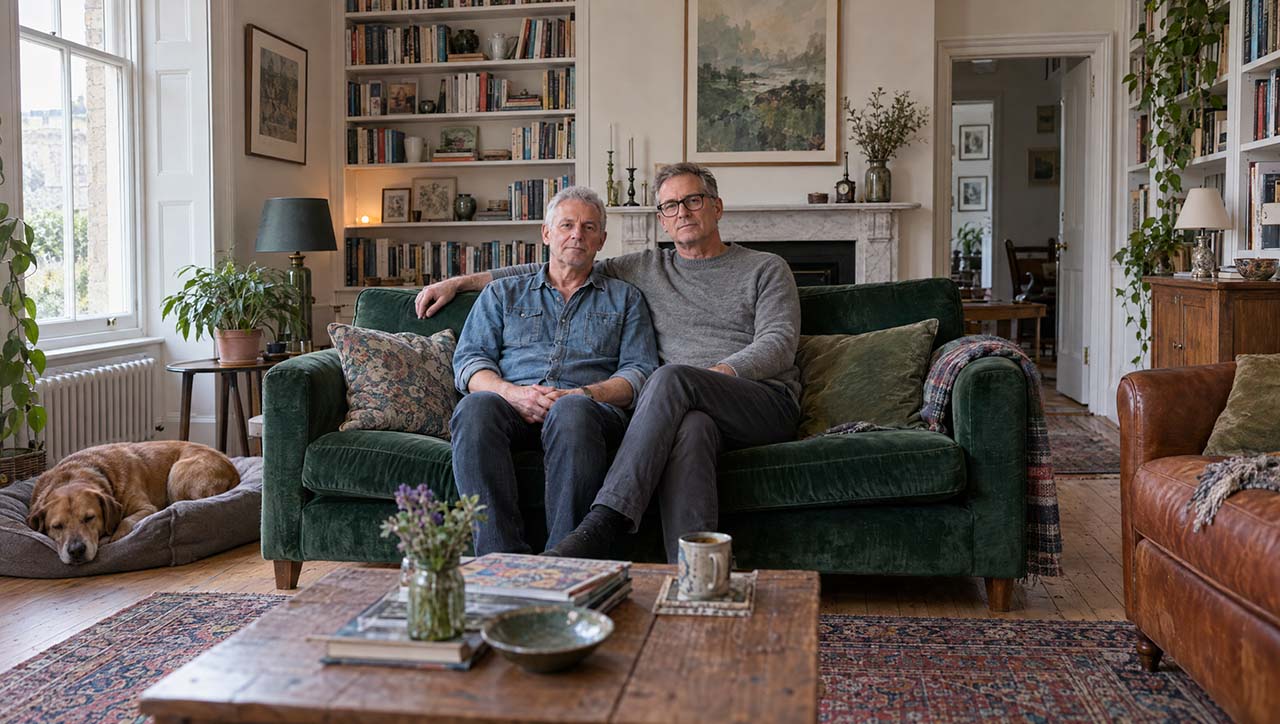
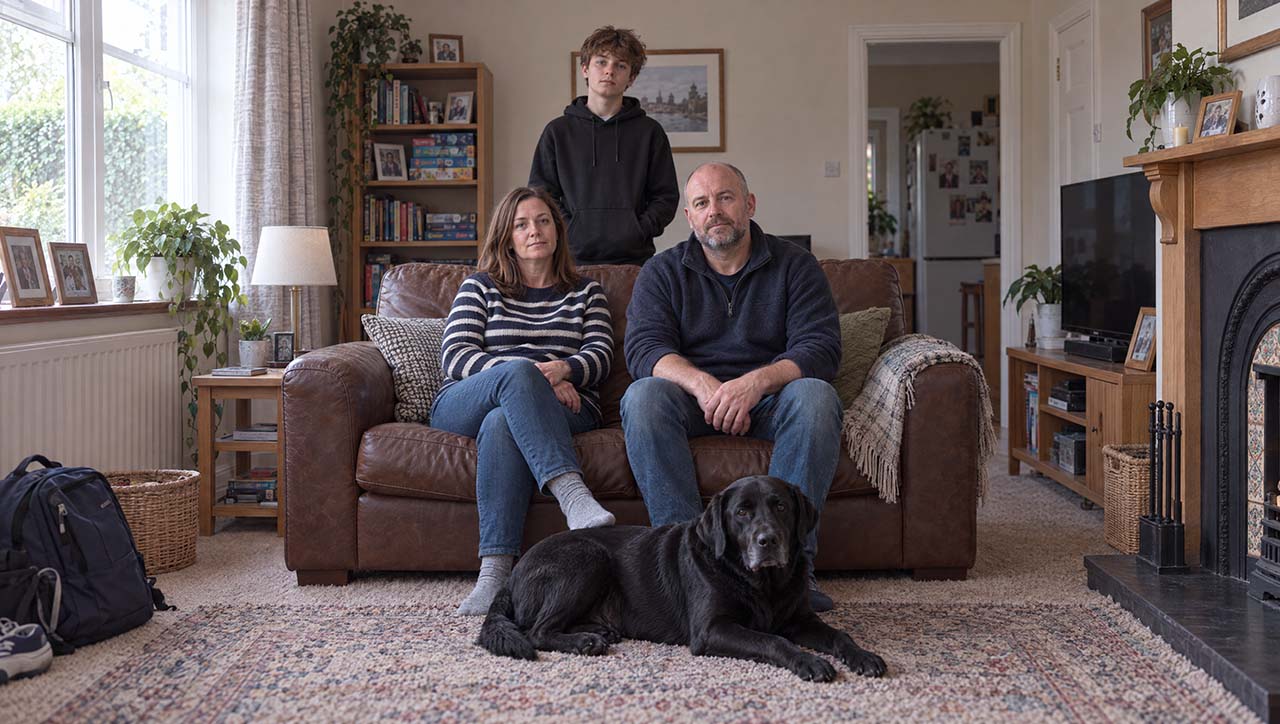
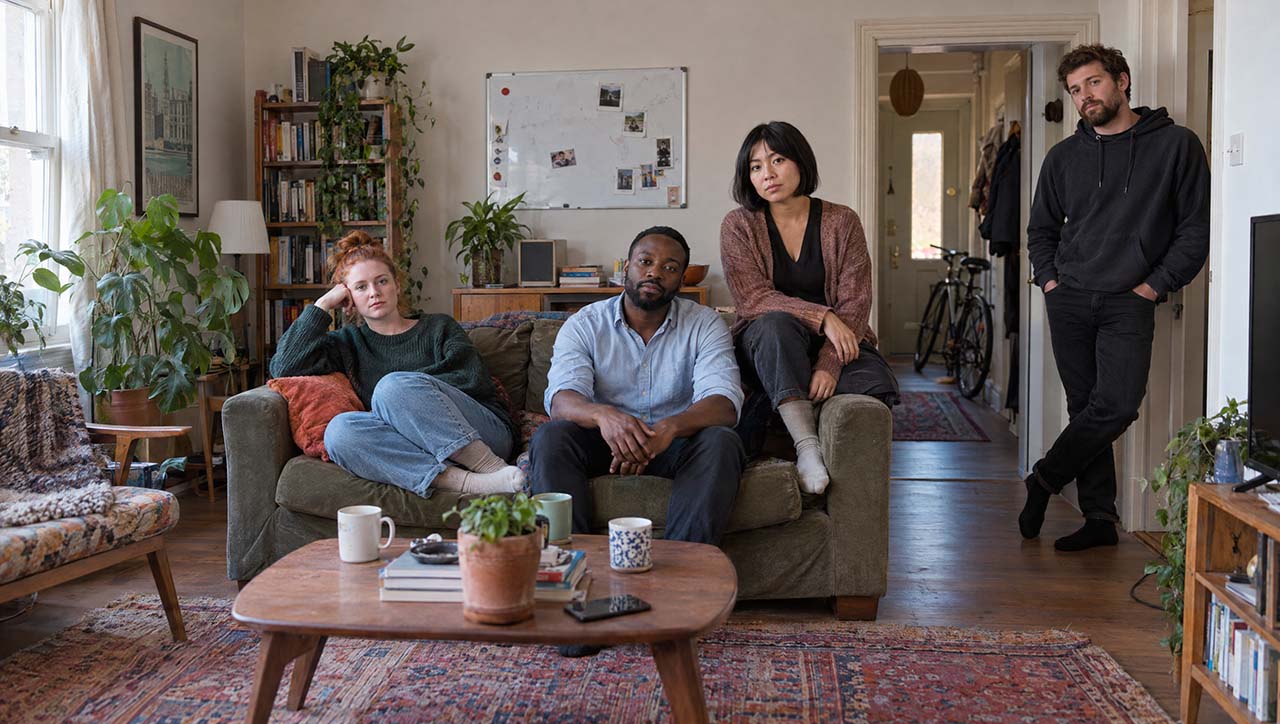
Hacia el final del vídeo, los mismos hogares vuelven, en movimiento. Primero posando, después viviendo.
Dirigir, no solo generar
La otra gran diferencia fue el control. Podíamos dirigir el vídeo. Para cada parte elegimos la óptica, la posición de cámara y el movimiento, igual que en un rodaje.
Dos secuencias del final lo muestran bien.
Bajo la frase «…combinando nuestras mejores metodologías para incorporar más hogares, compras y misiones de compra, captando en torno al triple de visitas a tienda», queríamos mostrar a gente en situaciones de compra. Usamos planos fijos con un 50 mm. Una focal normal, observando a distancia. La cámara mira a la gente comprar.
La frase siguiente es distinta: «Más comportamiento real observado. Más diferencias que mueven la demanda, en el foco. Una visión más clara de dónde está el crecimiento y qué hacer a continuación». Habla de comportamiento real, de cómo vive la gente de verdad. Así que volvimos a los mismos ocho hogares, ahora en casa alrededor de sus comidas, y pasamos a un 24 mm. Un angular permite a la cámara acercarse a la gente sin dejar de mostrar la habitación, como si estuviéramos allí con ellos. La cámara va en mano, avanzando ligeramente, para dar sensación de vida y de cambio.
El último plano rompe ese patrón a propósito. Después de siete planos inquietos, una mujer mayor en su salón, con el té entre las manos, mirando por la ventana. La cámara se mueve en un travelling lento y suave. Todo lo anterior se mueve. Ella está quieta.
Aquí es donde más importa saber de cine. La IA ha puesto la producción audiovisual al alcance de casi cualquiera. Pero el lenguaje visual es el mismo de siempre. Cámaras, ópticas, movimiento, luz. Si no sabes lo que hace un 24 mm o una cámara en mano, no puedes pedirlo.
Pero los modelos no siempre hacen lo que les pides. Cuando dimos con el prompt adecuado para esta secuencia, el movimiento de cámara funcionó bien en los cuatro o cinco primeros planos. Este era el prompt:
Handheld camera, clearly moving, carried forward by someone walking towards the table. No zoom: the lens stays wide, and the table and room shift in perspective as the camera gets closer.
Después empezó a fallar. La cámara hacía zoom en lugar de avanzar.
Para la mayoría del público esa diferencia puede parecer pequeña. Pero no lo es. Es justo el tipo de detalle que hace que un vídeo destaque.
Cambiamos el prompt de distintas formas, y seguía haciendo zoom. Nuestra mejor hipótesis es que algo en los fotogramas iniciales de esos planos empujaba al modelo hacia el zoom con más fuerza de la que el prompt lo alejaba. Pero es una hipótesis. Nadie puede ver dentro del modelo y decirte por qué.
Esta es la parte frustrante de trabajar con IA. Escribes algo que te parece completamente claro, y el modelo hace lo que quiere. Al final conseguimos el movimiento que necesitábamos, pero solo después de muchas generaciones y muchos pequeños cambios.
Los modelos te dan stock
Aquí hay una ironía. Pasamos a la IA para alejarnos del stock. Y lo primero que nos dieron los modelos de imagen fue fotografía de stock.
Las imágenes del presente salían bien iluminadas, bien compuestas y completamente muertas. Demasiado perfectas. Los hombres parecían modelos. La luz parecía HDR. Estos modelos aprenden de millones de imágenes, y muchas de ellas son de stock. Así que el stock es lo que dan por defecto.
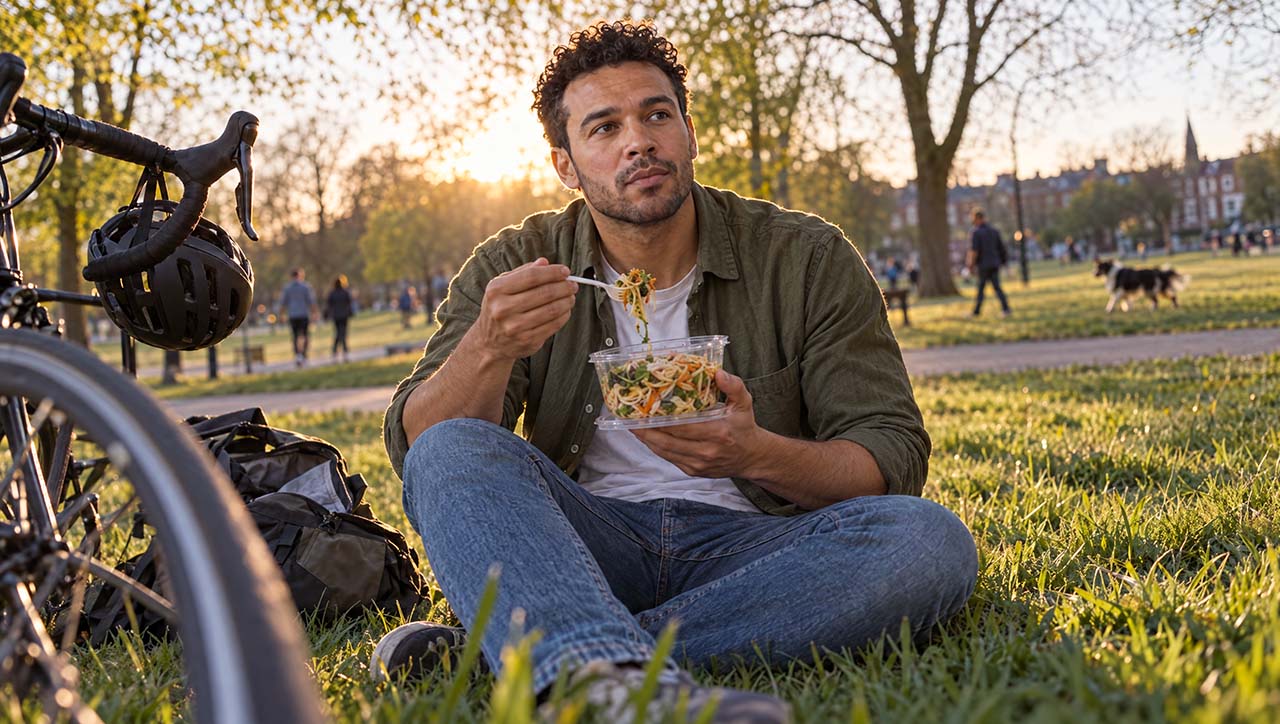
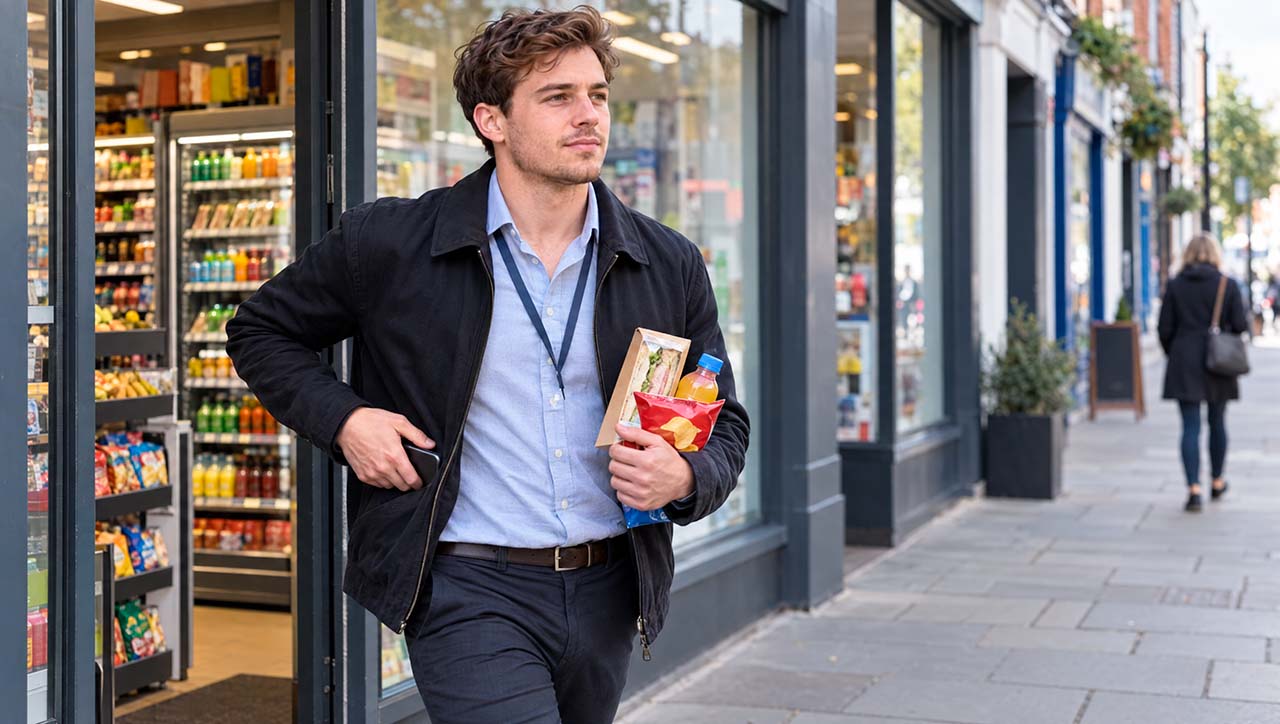
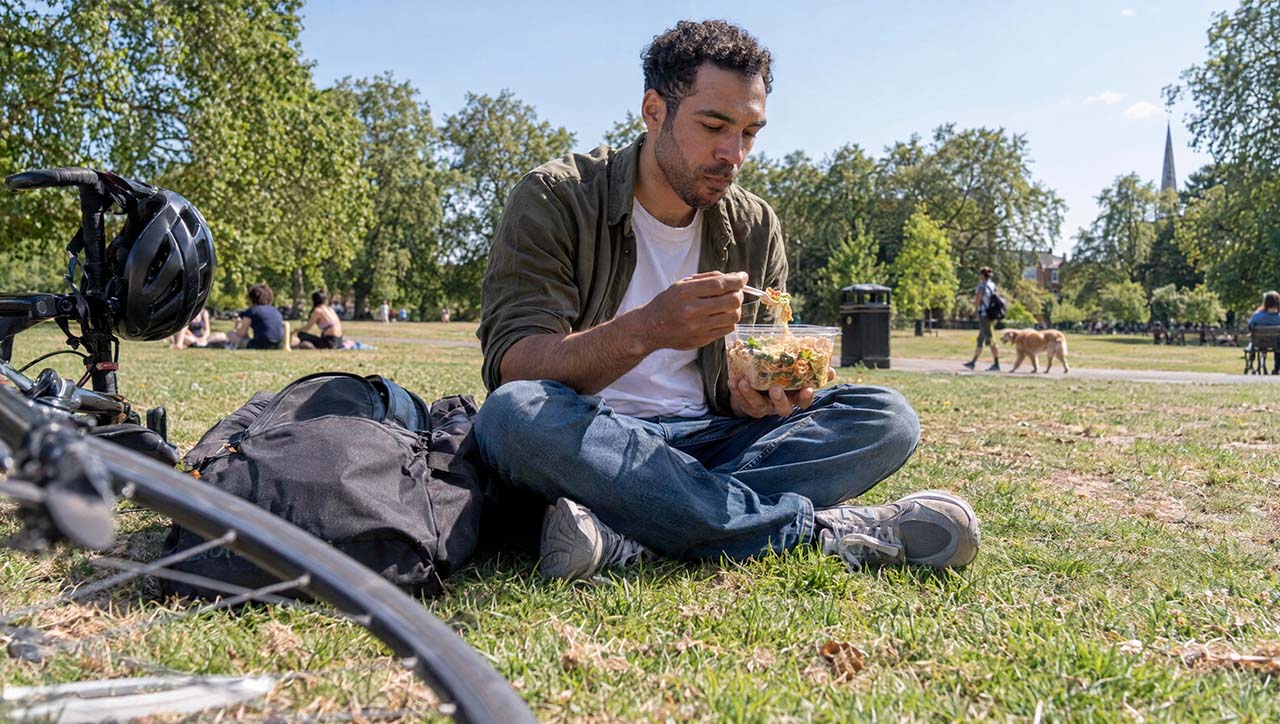
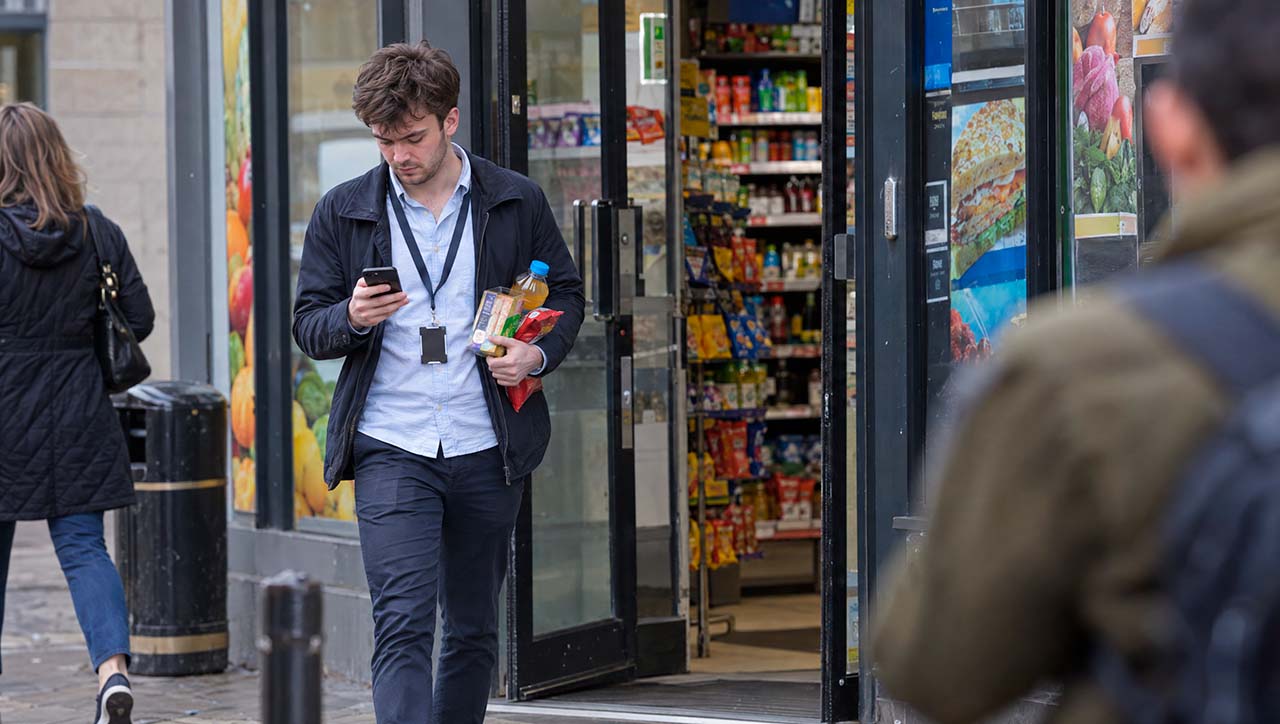
Alejarse de eso fue la mayor parte del trabajo del acto del presente. Lo que funcionó, por orden:
- Empieza por el encuadre, no por el sujeto. Todos los prompts empezaban con «A documentary photograph of everyday life in present-day Britain.»
- Elige a gente corriente. «An ordinary, unremarkable face.» «A slightly untidy haircut.» «Not a model.»
- Rompe la composición. Sujeto descentrado, alguien cortado por el borde del encuadre, algo desenfocado en primer término. Un momento captado, no preparado.
- Desordena el decorado,, de forma concreta. Huecos en las estanterías, una caja de producto a medio desembalar en el suelo, un tique caído. «Hazlo desordenado» no funciona. El desorden concreto, sí.
- Limita el rango dinámico. Una cámara real que expone para un cielo brillante no puede mantener a la vez una cara en sombra. Cuando una imagen mantiene las dos cosas, se percibe como falsa. Así que pedimos que la cara cayera en sombra, como pasaría en la realidad.
- Quita las palabras que pesan demasiado. «Golden hour» volvía naranja cada imagen. Describir cómo cae la luz funcionó mejor que nombrar la hora del día.
Las mismas personas, en más lugares
El momento del «three times the store visits» necesitaba una idea visual. Mostrar más compradores solo repetiría el mensaje de los 30.000 a 55.000 hogares que aparecía en pantalla justo antes. Así que recuperamos a personas que el público ya había visto y mostramos a cada una de nuevo en otra tienda. Las mismas personas, vistas más a menudo, en más lugares. Eso es lo que significa el triple de visitas a tienda.
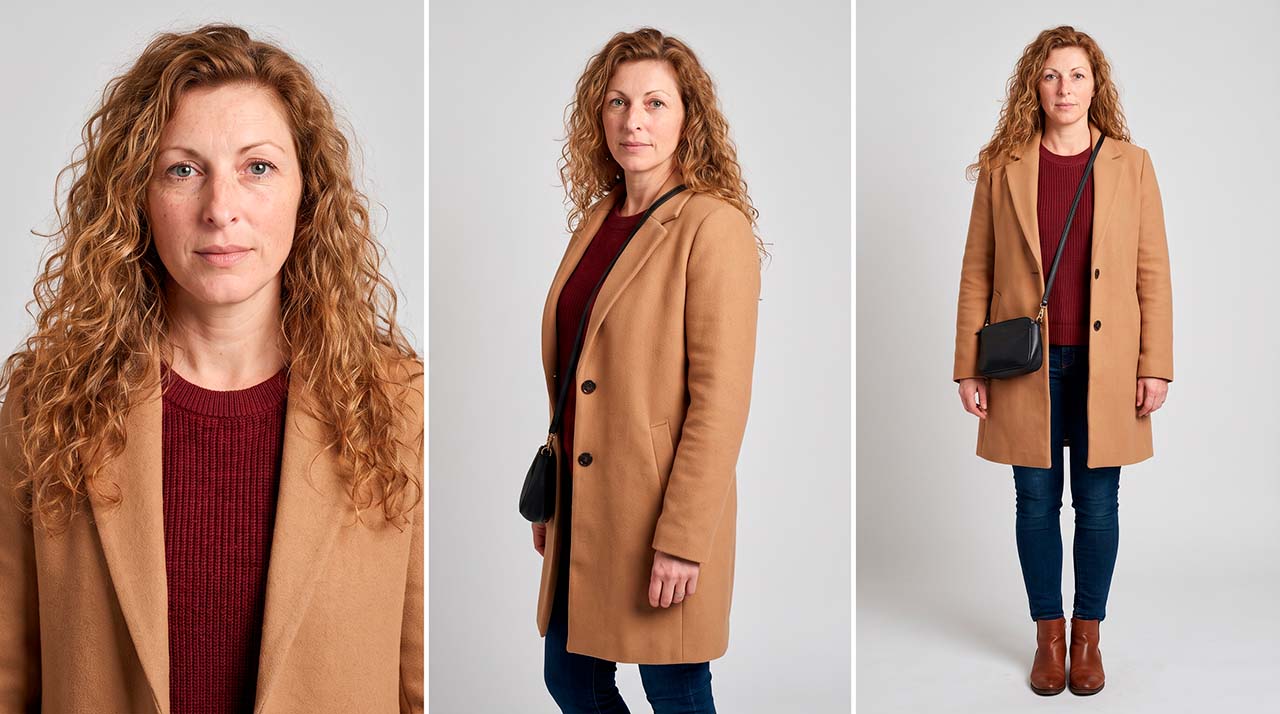
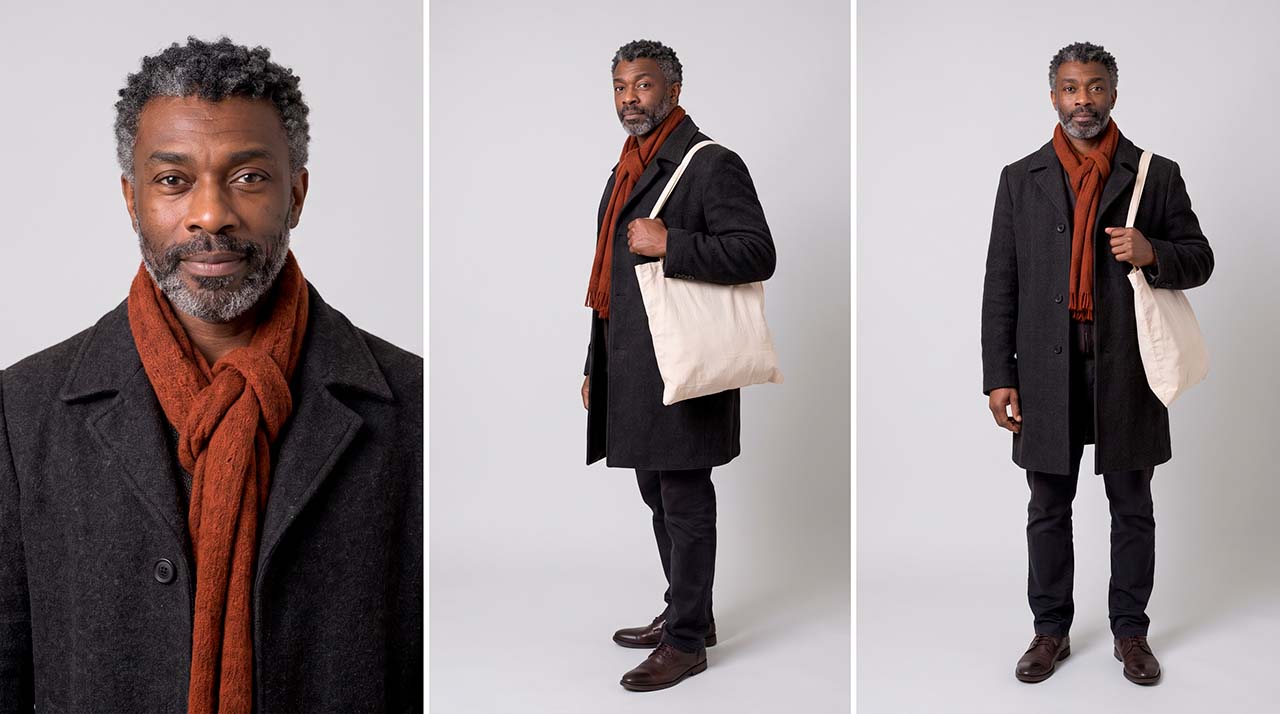
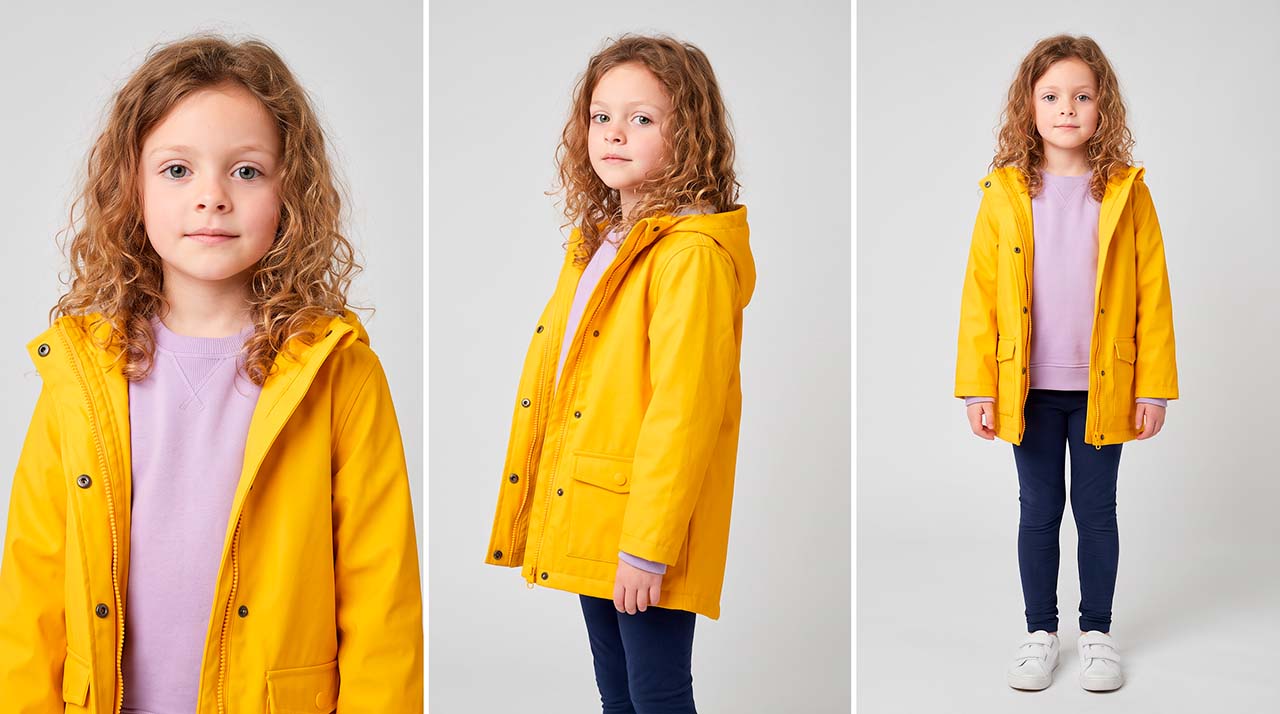
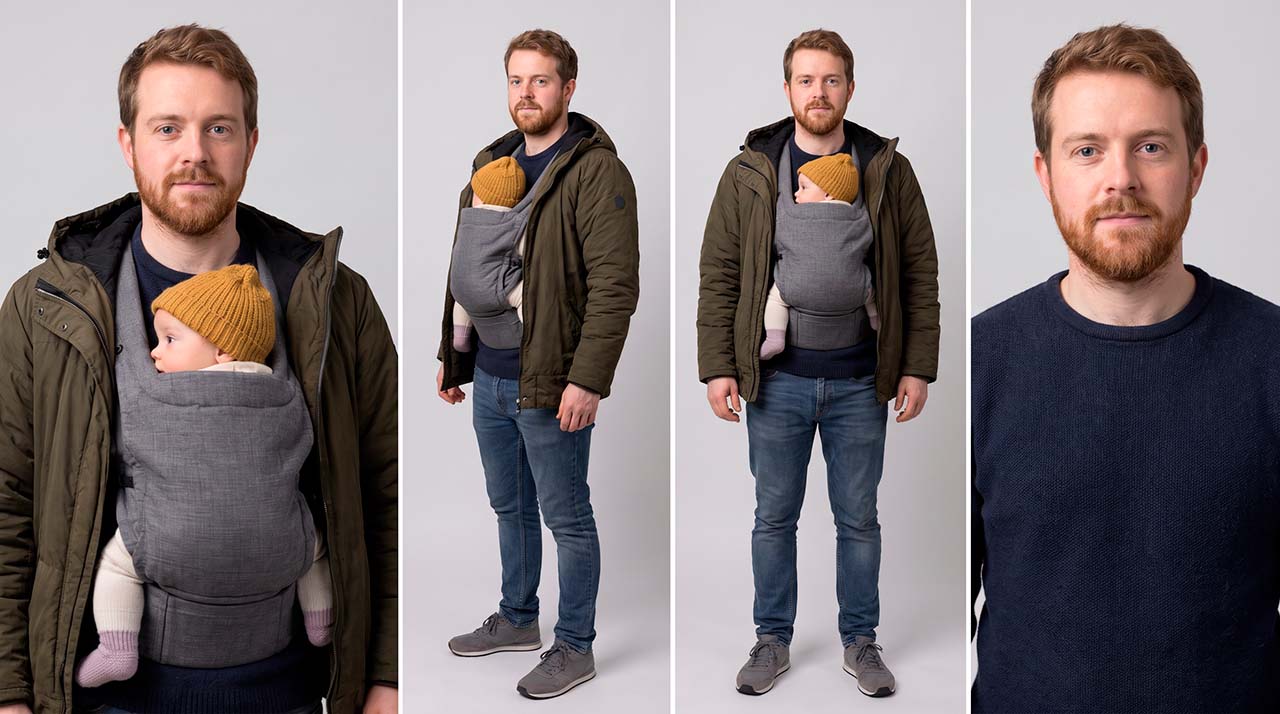
Un padre con un bebé en el pecho, al que vemos primero en un supermercado, vuelve a aparecer de noche en una tienda de conveniencia con un plato preparado. Un hombre de una frutería vuelve a aparecer en una caja atendida de un supermercado con el carro lleno, y otra vez en una gasolinera comprando flores. Una madre y su hija vuelven a aparecer en un supermercado de descuento y en una tienda de salud y belleza.
Con alrededor de un segundo por plano, el público tiene que reconocerlos al instante. Así que estos personajes también tuvieron ficha, con la ropa fijada como su principal seña: un abrigo camel, un chubasquero amarillo, una chaqueta verde oliva con una mochila portabebés gris y un gorro mostaza. A tamaño pequeño, a la gente se la reconoce por la ropa.
Lo que la IA todavía no sabe hacer
Si crees que la IA ya puede hacerlo todo, prueba con una nevera. Un frigorífico combi blanco, alto y normal, con una puerta abierta. Lo intentamos cuatro veces, con más detalle cada vez. Salía con dos puertas, o con una puerta compartida por dos compartimentos, o del tamaño equivocado. Al final nos quedamos con la mejor versión y seguimos adelante.
Algunos fallos venían del prompt, no del modelo. Un hombre se generó con tres brazos. El prompt le pedía estar recostado apoyado en una mano mientras comía de un táper con un tenedor. Eso necesita tres manos, así que el modelo le dio tres. Ahora contamos las manos que necesita una acción antes de escribirla.
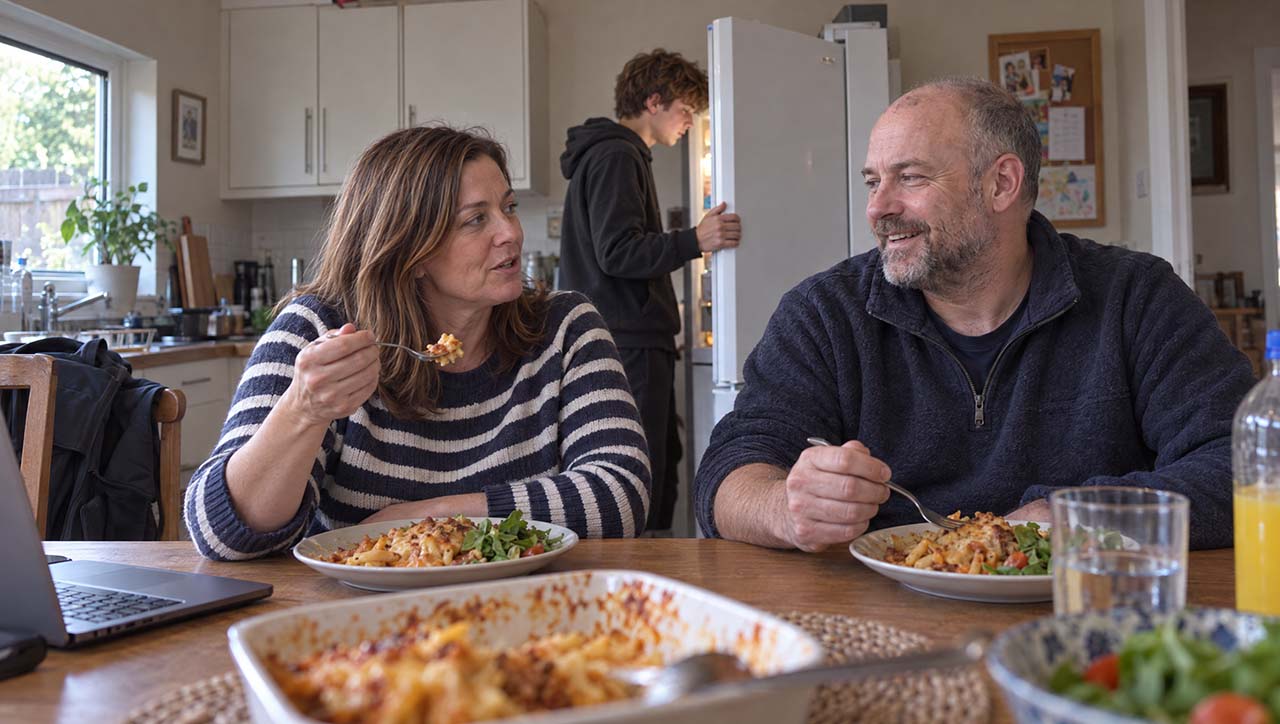
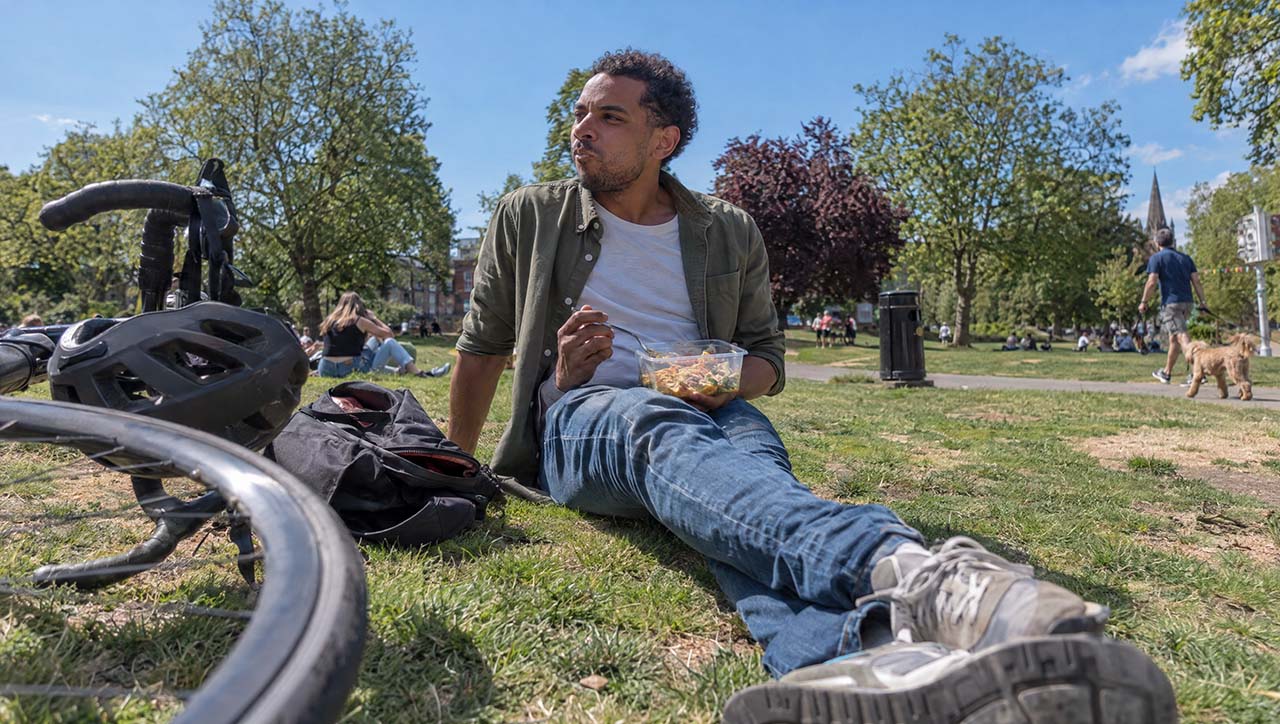
Y hay objetos que el modelo simplemente no conoce. Una cesta de la compra británica tiene dos asas, una en cada lado largo. El modelo insistía en darle una.
Algunos atajos tampoco funcionan todavía. Intentamos generar los ocho retratos de hogares de una vez, en un solo clip multiplano en Kling 3.0. Prometía ser rápido.
El resultado fue malo, y perdimos el control del encuadre, del casting y de la coherencia. Así que volvimos a nuestro método más lento: ocho fotogramas por separado, cada uno animado con el mismo prompt corto:
The people hold still and keep looking into the lens. They breathe naturally and blink. Small, involuntary movements only. Nobody speaks, smiles or waves. Static camera, locked off.
El camino lento es lento porque cada paso es una oportunidad de corregir algo. Esa es precisamente su ventaja.
Revisar cada fotograma
No aparece ninguna marca real en todo el vídeo. Se decidió desde el principio. Mantenerlo así exigió trabajo en cada fotograma.
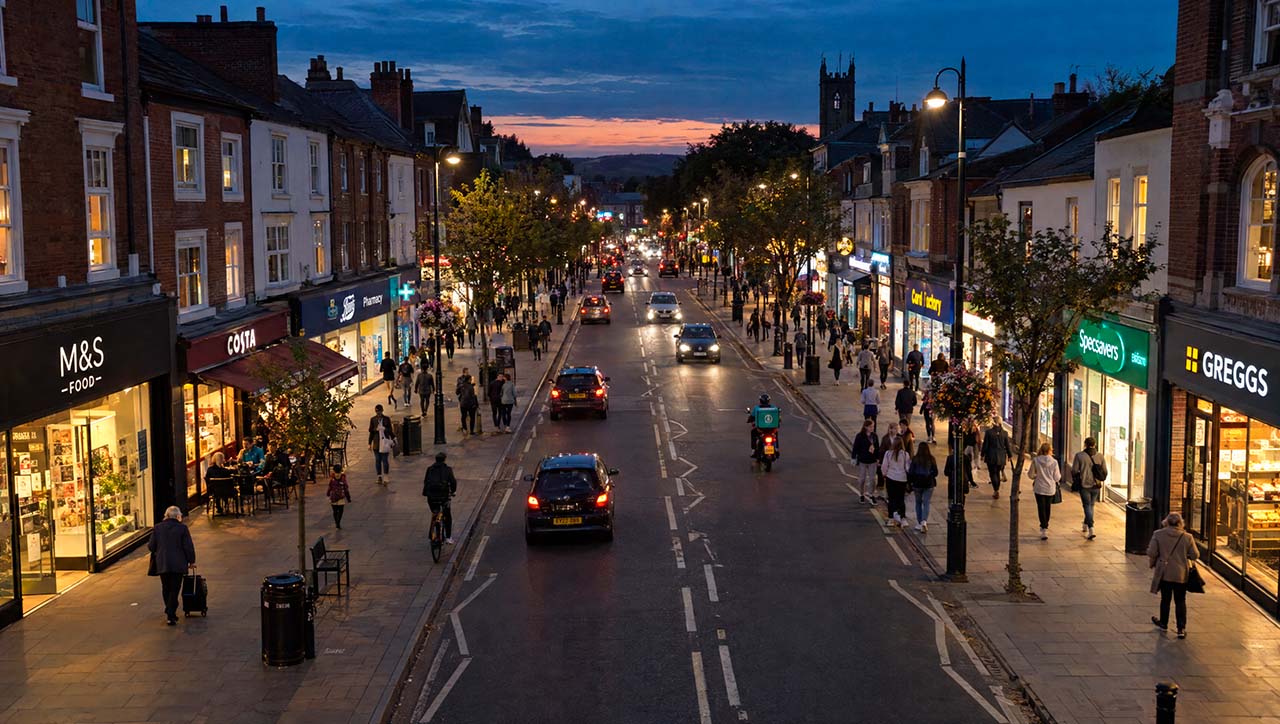
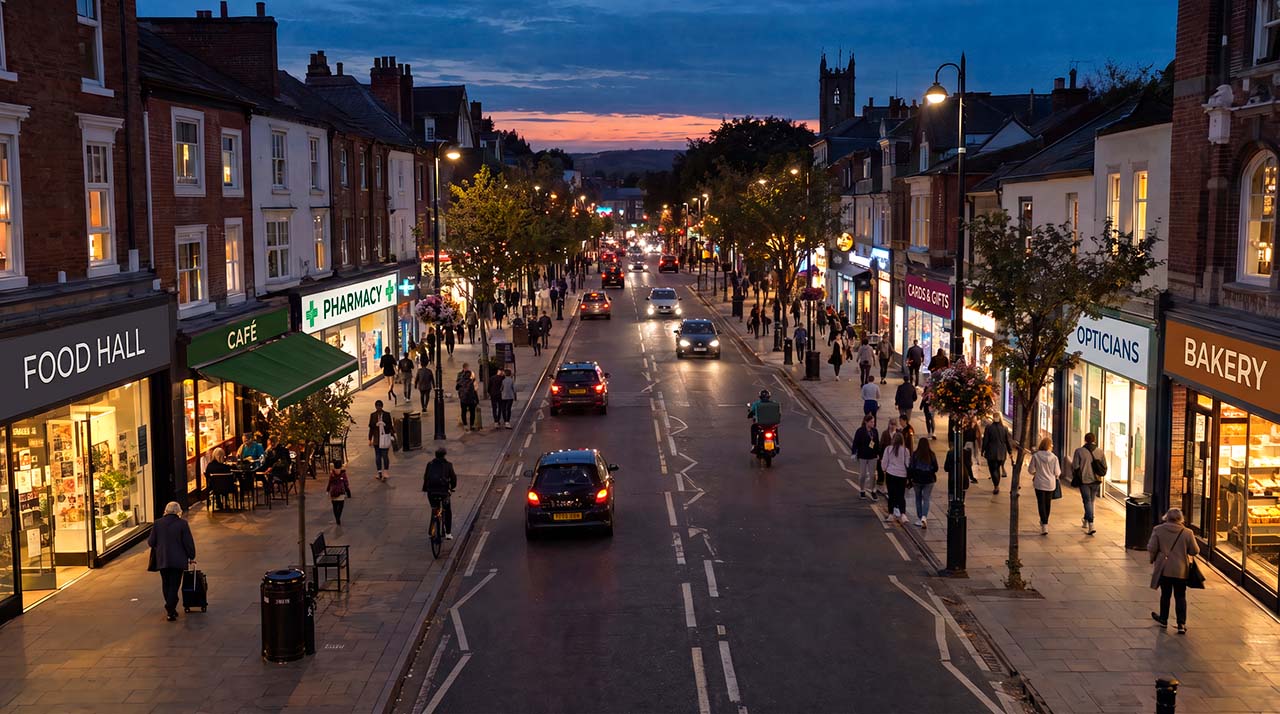
Un plano de dron de una calle comercial al atardecer salió con rótulos de tiendas reales a lo largo de toda la calle, todos legibles. Sustituimos cada uno por una palabra genérica: FOOD HALL, CAFÉ, PHARMACY, BAKERY. Palabras genéricas, no nombres inventados, porque un nombre inventado puede pertenecer a un negocio real en algún sitio, y los modelos escriben mejor las palabras cortas y comunes.
Las marcas también se cuelan sin logotipo. Una caja de pastillas para el lavavajillas salió con los colores exactos del líder del mercado, en una categoría cuyo fabricante estaba en la lista de invitados. La cambiamos a verde y blanco. Los pasillos del supermercado de descuento no podían ser azules y amarillos, ni rojos y amarillos.
Lo que ha cambiado para nosotros
Durante quince años, la pregunta en nuestro trabajo para Worldpanel fue «¿qué podemos encontrar?». En este vídeo, la pregunta pasó a ser «¿qué queremos mostrar?».
La IA no hizo el trabajo más ligero. Hizo posible un vídeo distinto (y mejor).
Con el stock, partíamos de lo que existía. Worldpanel nos enviaba el guion. Buscábamos en los bancos de imágenes clips para cada frase y rellenábamos los huecos con lo que más se acercaba. Cuando el clip que debía transmitir una idea no existía, el vídeo acababa con planos que ocupaban tiempo en pantalla sin decir nada.
Había un segundo problema: la coherencia. Cada clip de stock viene de un sitio distinto. Se grabó en otro momento, con otra cámara y otra óptica, por otra persona, con otra luz. Juntar veinte de esos clips y que parezcan un solo vídeo es casi imposible. Y no es solo una cuestión de estética. También es cultural. Un vídeo para un público británico tiene que parecer Gran Bretaña, no Estados Unidos, España u Oriente Medio. Los bancos de imágenes rara vez te permiten ser tan específico.
En este vídeo, cada plano salió del mismo estilo fotográfico, las mismas referencias y las mismas reglas. Parece un solo vídeo porque se hizo como un solo vídeo.
También nos permitió partir de la idea. Si la voz en off hablaba de la frecuencia con la que la gente compra, podíamos mostrar una cesta con pan, plátanos y una botella de leche, y nada más. Si hablaba de los mismos hogares vistos más a menudo, podíamos mostrar a las mismas personas en tiendas distintas. Cada plano podía estar ahí por un motivo.
Ese es el cambio real para nosotros. Ya no rellenamos huecos. Construimos el vídeo que tenemos en la cabeza.

